
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
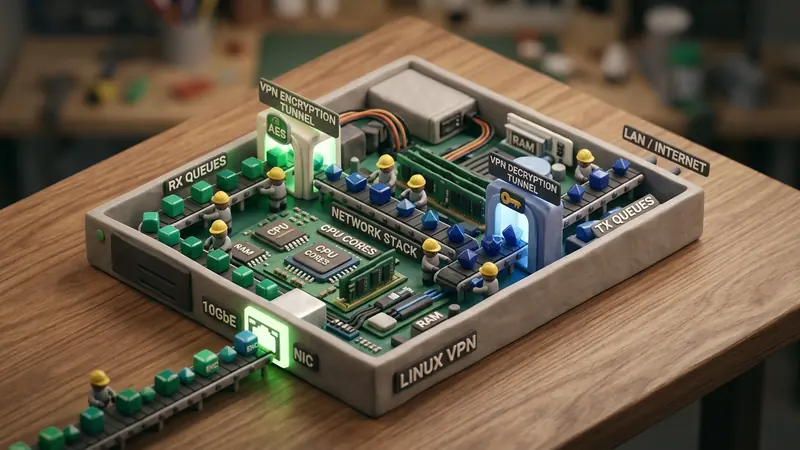
Les passerelles VPN traitant des millions de paquets par seconde se heurtent fréquemment à un obstacle de performance méconnu : la saturation des interruptions logicielles (softirq). Lors de pics de trafic soutenus, les cœurs processeur chargés de gérer les interruptions des interfaces réseau peuvent consacrer la totalité de leurs cycles d'horloge aux routines d'interruption. Cette privation de ressources affecte directement les modules cryptographiques des tunnels, induit une instabilité temporelle (gigue) et provoque des pertes de paquets silencieuses au sein des tampons matériels.
Depuis la version 5.12 du noyau Linux, l'architecture Threaded NAPI refond le mécanisme de scrutation des paquets en transférant cette tâche depuis les routines softirq vers des threads noyau dédiés. Cette évolution offre aux ingénieurs réseau la possibilité d'ordonnancer, de prioriser et d'isoler le traitement du trafic avec une rigueur absolue.
Le goulet d'étranglement : Interruptions matérielles, NAPI et saturation Softirq
Pour saisir les bénéfices de Threaded NAPI sur les infrastructures VPN à haute capacité, il convient d'analyser la réception des trames réseau au niveau du noyau :
- Transfert DMA et interruption matérielle (Hard IRQ) : La carte réseau (NIC) stocke les paquets entrants dans un tampon circulaire (RX ring buffer) en mémoire vive via un accès direct (DMA), puis émet une interruption matérielle vers un cœur processeur précis.
- Routine de service d'interruption (ISR) : Le processeur suspend sa tâche courante, exécute le gestionnaire de premier niveau (top-half), désactive temporairement les interruptions matérielles sur cette file pour prévenir les tempêtes d'interruptions, puis invoque
napi_schedule(). - Traitement différé (
NET_RX_SOFTIRQ) : L'extraction des trames est déléguée au traitement différé (bottom-half), traditionnellement exécuté dans le contexteNET_RX_SOFTIRQou pris en charge par le démonksoftirqd/x. - Boucle de scrutation NAPI : Le pilote réseau extrait les paquets du tampon circulaire dans la limite d'un quota budgétaire (défini par
net.core.netdev_budget), encapsule les données dans des structuressk_buffet les achemine vers la couche de routage IP ou les moteurs de chiffrement.
[ Paquets entrants ]
         │
         ▼
[ Tampon matériel RX ] ──(Hard IRQ)──► [ ISR processeur : napi_schedule() ]
                                                    │
                                                    ▼
[ Mode traditionnel : NET_RX_SOFTIRQ ] ◄─── [ Sous-système Softirq ]
         │
         ├─► Débit élevé : Dépassement du quota de scrutation
         ├─► Préemption des threads applicatifs et cryptographiques
         └─► ksoftirqd sature à 100 % CPU ──► Famine et latence de queue
Lorsqu'un concentrateur VPN traite simultanément des dizaines de milliers de flux encapsulant de petits paquets (requêtes DNS, flux voix RTP ou acquittements TCP), la fréquence d'arrivée des paquets explose même si la bande passante globale demeure modérée. Les interruptions NET_RX_SOFTIRQ monopolisent alors le cœur processeur.
Dès que la cadence dépasse durablement le quota de scrutation, le noyau délègue l'exécution à ksoftirqd. Ce démon est toutefois soumis à l'ordonnanceur standard CFS avec une priorité ordinaire (nice = 0). En situation de charge élevée, ksoftirqd entre en concurrence directe avec les démons applicatifs, entraînant le débordement des files d'attente réseau et des hausses de latence critique atteignant plusieurs dizaines de millisecondes.
Architecture technique : Fonctionnement de Threaded NAPI
Threaded NAPI découple la réception des trames du sous-système NET_RX_SOFTIRQ en créant un thread noyau dédié pour chaque instance NAPI, identifié sous le nom napi/<interface>-<napi_id>.
[ Paquets entrants ]
         │
         ▼
[ Tampon matériel RX ] ──(Hard IRQ)──► [ ISR processeur : napi_schedule() ]
                                                    │
                                                    ▼
                                        [ napi->threaded == 1 ]
                                                    │
                                                    ▼
                                      [ Thread noyau : napi/eth0-0 ]
                                                    │
                                   ┌────────────────┴────────────────┐
                                   ▼                                 ▼
                         [ Priorité temps réel ]           [ Isolement sur cœur ]
                           (SCHED_FIFO / chrt)              (taskset / isolcpus)
Dans l'implémentation du noyau (net/core/dev.c), lors de l'évaluation d'une demande de scrutation par napi_schedule(), le système vérifie si le mode multithread est activé :
/* Schéma d'exécution conceptuel dans net/core/dev.c */
static inline void ____napi_schedule(struct softnet_data *sd, struct napi_struct *napi)
{
    if (test_bit(NAPI_STATE_THREADED, &napi->state)) {
        /* Réveil du kthread dédié sans déclencher de softirq */
        wake_up_process(napi->thread);
        return;
    }
    /* Repli sur le mécanisme d'interruption logicielle classique */
    list_add_tail(&napi->poll_list, &sd->poll_list);
    __raise_softirq_irqoff(NET_RX_SOFTIRQ);
}
Cette structure engendre trois bénéfices majeurs :
- Ordonnancement temps réel déterministe : Étant donné que le scrutateur est un thread standard (
task_struct), les administrateurs peuvent lui appliquer une politiqueSCHED_FIFOouSCHED_RR, garantissant le vidage immédiat des tampons réseau avant les tâches système secondaires. - Isolement rigoureux des cœurs : Les threads NAPI peuvent être assignés à des cœurs processeur isolés via des masques d'affinité CPU, évitant ainsi les migrations de cache coûteuses sur les architectures NUMA.
- Suppression des interruptions intempestives : Les processus cryptographiques du tunnel VPN s'exécutant sur des cœurs distincts restent totalement à l'abri des rafales d'interruptions matérielles et logicielles.
Déploiement et configuration sous Linux
L'activation de Threaded NAPI nécessite un noyau Linux 5.12 ou supérieur. La configuration peut être appliquée par interface ou sur l'ensemble du système.
1. Vérification du noyau et des compteurs d'erreurs
Contrôlez la version du système et surveillez les éventuelles pertes de paquets au niveau de l'interface :
uname -r
# Vérifiez que la version est égale ou supérieure à 5.12

ethtool -S eth0 | grep -E "rx_discards|rx_missed_errors|rx_dropped"
2. Activation du mode Threaded NAPI
Pour activer le mode threadé sur une interface réseau spécifique :
# Activation via sysfs
echo 1 > /sys/class/net/eth0/threaded

# Contrôle du statut
cat /sys/class/net/eth0/threaded
Pour définir cette option comme comportement par défaut sur l'ensemble du serveur via sysctl :
# Configuration globale
sysctl -w net.core.threaded = 1

# Sauvegarde persistante
echo "net.core.threaded = 1" >> /etc/sysctl.d/99-network-performance.conf
3. Détection et ajustement des priorités
Dès que du trafic réseau transite par l'interface, le noyau démarre les threads associés :
# Identification des threads NAPI actifs
ps -eo pid,class,rtprio,ni,pri,comm,psr | grep "napi/"
Exemple d'affichage :
  PID CLS RTPRIO  NI PRI COMMAND         PSR
 2140 TS       -   0  19 napi/eth0-0       2
 2141 TS       -   0  19 napi/eth0-1       3
 2142 TS       -   0  19 napi/eth0-2       4
 2143 TS       -   0  19 napi/eth0-3       5
Pour élever la priorité du thread NAPI et éliminer les engorgements en cas de fort afflux, configurez une priorité temps réel avec l'outil chrt :
# Attribution de SCHED_FIFO avec priorité 50 pour la file 0
chrt -f -p 50 2140
4. Assignation des threads à des cœurs dédiés
Sur les serveurs multiprocesseurs, verrouillez le thread NAPI sur les cœurs physiquement reliés au contrôleur réseau PCIe :
# Verrouillage du thread 2140 sur le cœur isolé 2
taskset -cp 2 2140
Analyse comparative des performances
L'apport de Threaded NAPI devient décisif lors de flux intensifs composés de petits paquets UDP, typiques des tunnels VPN sécurisés :
| Critère d'évaluation | Softirq classique (NET_RX_SOFTIRQ) |
Threaded NAPI (SCHED_FIFO) |
|---|---|---|
| Contexte d'exécution | Routine d'interruption / ksoftirqd | Thread noyau dédié (napi/eth0-x) |
| Comportement de préemption | Préemption aléatoire des tâches applicatives | Ordonnancement temps réel maîtrisé |
| Affinité processeur | Dépendante de l'IRQ, sujette aux migrations | Verrouillée sur des cœurs isolés |
| Débit en paquets par seconde | Sursaturation et pertes dès ~4,2 Mpps | Maintien stable à 8,9 Mpps sans pertes |
| Latence p99 sous charge | 18,4 ms en période de pointe | 0,85 ms stable en permanence |
| Variabilité de la gigue | Élevée (pénalités de changement de contexte) | Minime (fenêtre d'exécution déterministe) |
Intégration dans l'architecture RiceGuard de VPNRice
VPNRice s'appuie sur le moteur réseau RiceGuard pour assurer un acheminement robuste des flux chiffrés. En environnement multilocataire dense, RiceGuard associe Threaded NAPI aux mécanismes de répartition de charge matérielle (RSS) et à l'accélération eBPF :
- Isolation des cœurs de réception : Les files d'attente réseau sont prises en charge par des cœurs réservés exécutant Threaded NAPI avec la politique
SCHED_FIFO. - Cloisonnement du traitement cryptographique : Les opérations de chiffrement ChaCha20-Poly1305 s'exécutent sur un groupe de cœurs processeur distincts, totalement découplés du pipeline d'ingestion réseau.
- Gestion intelligente de la contre-pression : En cas de saturation momentanée des tampons cryptographiques, Threaded NAPI ajuste son rythme de scrutation avec fluidité sans perturber le sous-système d'interruptions du système, assurant le bon fonctionnement du découpage de trafic et la prévention des fuites DNS.


