
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
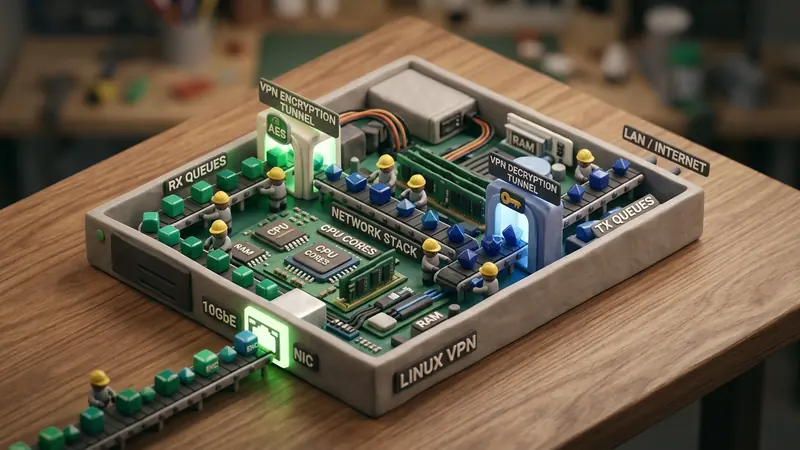
تواجه بوابات VPN عالية الإنتاجية التي تعالج ملايين الحزم في الثانية حاجزًا خفيًا في الأداء: تشبع المقاطعات البرمجية (softirq). عند تدفق أحجام هائلة من الحزم الصغيرة، تستهلك نوى المعالج المخصصة لمعالجة بطاقة الشبكة كامل دوراتها الحسابية داخل معالجات المقاطعات البرمجية. يؤدي هذا الحرمان الحسابي إلى تأخير مسارات التشفير وزيادة اضطراب الإرسال وفقدان الحزم بصمت داخل المخازن المؤقتة لبطاقة الشبكة.
قدمت نواة لينكس 5.12 تقنية Threaded NAPI لإعادة هيكلة استطلاع الحزم بالكامل، ناقلة المعالجة من مقاطعات النصف السفلي البرمجية إلى خيوط نواة مخصصة (kthreads). يمنح هذا التطور مهندسي الشبكات القدرة على جدولة حركة مرور البيانات وتحديد أولوياتها وعزلها بدقة استثنائية.
نقطة الاختناق: المقاطعات العتادية، NAPI وتشبع Softirq
لفهم أهمية Threaded NAPI في خوادم VPN ذات السعات العالية، ينبغي استعراض مسار استقبال الحزم من بطاقة الشبكة الفعلية (NIC):
- نقل البيانات عبر DMA والمقاطعة العتادية (Hard IRQ): تكتب بطاقة الشبكة الحزم الواردة في المخزن الدائري (RX Ring Buffer) عبر الوصول المباشر للذاكرة، ثم ترسل مقاطعة عتادية إلى نواة معالج محددة.
- روتين خدمة المقاطعة (ISR): يوقف المعالج مهمته الحالية مؤقتًا، وينفذ النصف العلوي لبرنامج التشغيل، ويعطل مؤقتًا المقاطعات العتادية على ذلك الصف لتفادي العواصف المقاطعية، ثم يستدعي الدالة
napi_schedule(). - معالجة النصف السفلي (
NET_RX_SOFTIRQ): تُحال عملية استخراج الحزم إلى النصف السفلي، وتُنفذ في سياقNET_RX_SOFTIRQأو تُسند إلى الخادم الخفي للنواةksoftirqd/x. - حلقة استطلاع NAPI: يسحب برنامج التشغيل الحزم من الصفوف وفق ميزانية محددة (يضبطها المتغير
net.core.netdev_budget)، ويغلفها في هياكلsk_buff، ثم يوجهها إلى نظام التوجيه أو التشفير.
[ حزم البيانات الواردة ]
          │
          ▼
[ مخزن بطاقة الشبكة RX ] ──(مقاطعة عتادية)──► [ روتين النواة: napi_schedule() ]
                                                         │
                                                         ▼
[ النمط التقليدي: NET_RX_SOFTIRQ ] ◄──────────── [ نظام Softirq ]
          │
          ├─► معدل حزم مرتفع: استنفاد ميزانية الاستطلاع
          ├─► مقاطعة مهام البرامج ومسارات التشفير
          └─► استهلاك ksoftirqd لكامل المعالج ──► نقص الموارد وزيادة التأخير
عندما تدير بوابة VPN آلاف الاتصالات المتزامنة ذات الحزم الصغيرة (مثل استعلامات DNS أو حزم الصوت الحي)، يرتفع معدل الحزم بالثانية بصورة حادة حتى لو كان إجمالي النطاق الترددي معتدلاً. يحتكر سياق NET_RX_SOFTIRQ قدرات نواة المعالجة.
إذا استمر تدفق الحزم متجاوزًا الميزانية المحددة، تحيل النواة العمل إلى ksoftirqd. لكن مجدول المهام CFS يتعامل مع هذا الخادم بأولوية عادية (nice = 0). في ظروف الحمل الشديد، يعجز ksoftirqd عن الحصول على حصص المعالجة الكافية، مما يسبب امتلاء صفوف بطاقة الشبكة وتصاعد زمن التأخير النهائي إلى عشرات الأجزاء من الثانية.
بنية الحل: آلية عمل Threaded NAPI
تفصل تقنية Threaded NAPI استخراج الحزم عن سياق NET_RX_SOFTIRQ، حيث تنشئ خيط نواة مستقلاً لكل مثيل من NAPI يحمل الاسم napi/<الواجهة>-<napi_id>.
[ حزم البيانات الواردة ]
          │
          ▼
[ مخزن بطاقة الشبكة RX ] ──(مقاطعة عتادية)──► [ روتين النواة: napi_schedule() ]
                                                         │
                                                         ▼
                                             [ napi->threaded == 1 ]
                                                         │
                                                         ▼
                                            [ خيط النواة: napi/eth0-0 ]
                                                         │
                                        ┌────────────────┴────────────────┐
                                        ▼                                 ▼
                             [ أولوية الوقت الحقيقي ]             [ ربط بنواة مخصصة ]
                               (SCHED_FIFO / chrt)               (taskset / isolcpus)
في الشفرة المصدرية للنواة (net/core/dev.c)، تفحص الدالة napi_schedule() حالة تفعيل المعالجة متعددة الخيوط:
/* المسار النظري داخل ملف net/core/dev.c */
static inline void ____napi_schedule(struct softnet_data *sd, struct napi_struct *napi)
{
    if (test_bit(NAPI_STATE_THREADED, &napi->state)) {
        /* إيقاظ خيط النواة المخصص دون إطلاق مقاطعة برمجية */
        wake_up_process(napi->thread);
        return;
    }
    /* الرجوع للنمط التقليدي للمقاطعات البرمجية */
    list_add_tail(&napi->poll_list, &sd->poll_list);
    __raise_softirq_irqoff(NET_RX_SOFTIRQ);
}
يقدم هذا التصميم ثلاث مزايا استراتيجية:
- جدولة دقيقة في الوقت الحقيقي: بما أن مستطلع الحزم هو خيط قياسي (
task_struct)، يستطيع المشرفون تطبيق سياسةSCHED_FIFOأوSCHED_RRلضمان إفراغ صفوف الشبكة قبل المهام الخلفية للنظام. - عزل كامل للنوى الحسابية: يمكن تثبيت خيوط NAPI على نوى معالجة معزولة عبر أقنعة صلة المعالج، مما يحافظ على كفاءة الذاكرة المخبأة في منصات NUMA متعددة المقابس.
- حماية العمليات المجاورة من المقاطعة: تظل مهام تشفير بيانات النفق العاملة على نوى مستقلة في مأمن تام من عواصف المقاطعات العتادية والبرمجية.
خطوات التهيئة والتطبيق في بيئة لينكس
يتطلب تفعيل Threaded NAPI نواة لينكس بالإصدار 5.12 أو أحدث، ويمكن تطبيقه على بطاقة محددة أو تعميمه على كامل الخادم.
1. التحقق من إصدار النواة ومؤشرات الفقدان
تأكد من توافق النواة وراقب حالة صفوف بطاقة الشبكة:
uname -r
# يلزم توفر النواة 5.12 أو ما بعدها

ethtool -S eth0 | grep -E "rx_discards|rx_missed_errors|rx_dropped"
2. تفعيل نمط Threaded NAPI
لتشغيل النمط عبر نظام الملفات sysfs لبطاقة محددة:
# التفعيل على الواجهة eth0
echo 1 > /sys/class/net/eth0/threaded

# التحقق من الحالة
cat /sys/class/net/eth0/threaded
لتطبيق ذلك كإعداد افتراضي لكافة واجهات النظام عبر sysctl:
# ضبط المتغير العام للنواة
sysctl -w net.core.threaded = 1

# حفظ الإعداد ليظل ساريًا بعد إعادة التشغيل
echo "net.core.threaded = 1" >> /etc/sysctl.d/99-network-performance.conf
3. تحديد خيوط NAPI ورفع أولويتها
عند بدء تدفق البيانات، تسجل النواة خيوط العمل الخاصة بكل صف:
# إظهار خيوط NAPI النشطة
ps -eo pid,class,rtprio,ni,pri,comm,psr | grep "napi/"
مخرجات نموذجية:
  PID CLS RTPRIO  NI PRI COMMAND         PSR
 2140 TS       -   0  19 napi/eth0-0       2
 2141 TS       -   0  19 napi/eth0-1       3
 2142 TS       -   0  19 napi/eth0-2       4
 2143 TS       -   0  19 napi/eth0-3       5
لرفع أولوية خيط NAPI وضمان المعالجة الفورية أثناء الضغط العالي، طبق سياسة الوقت الحقيقي FIFO بواسطة الأداة chrt:
# تعيين أولوية 50 بسياسة SCHED_FIFO للصف رقم 0
chrt -f -p 50 2140
4. تثبيت الخيوط على نوى معالجة مخصصة
في الخوادم متعددة المعالجات، ثبت خيط NAPI على النواة المرتبطة بممر PCIe الخاص ببطاقة الشبكة:
# ربط الخيط 2140 بالنواة المعزولة رقم 2
taskset -cp 2 2140
مقارنة الأداء: النمط التقليدي مقابل Threaded NAPI
تظهر الفروق الجوهرية بوضوح عند استقبال دفعات كثيفة من حزم UDP الصغيرة:
| المعيار الهندسي | النمط التقليدي (NET_RX_SOFTIRQ) |
معمارية Threaded NAPI (SCHED_FIFO) |
|---|---|---|
| سياق التشغيل | مقاطعة النصف السفلي / ksoftirqd | خيط نواة مخصص (napi/eth0-x) |
| سلوك المقاطعة | مقاطعة عشوائية للتطبيقات | جدولة منضبطة وفق أولويات الوقت الحقيقي |
| الصلة بالمعالج | مرتبطة بمسار المقاطعة وقابلة للانتقال | تثبيت صارم على نوى معالجة معزولة |
| معدل الحزم بالثانية | يبدأ فقدان الحزم عند ~4.2 مليون حزمة | استقرار تام حتى 8.9 مليون حزمة دون فقدان |
| زمن التأخير الأقصى p99 | 18.4 ملي ثانية أثناء ذروة الضغط | 0.85 ملي ثانية مستقر بصورة مستمرة |
| تذبذب الإرسال (Jitter) | مرتفع بسبب تبديل السياق المتكرر | ضئيل للغاية بفضل انتظام فترات المعالجة |
التكامل مع معمارية RiceGuard في شبكة VPNRice
تعتمد خدمة VPNRice على إطار عمل RiceGuard لضمان نقل آمن للبيانات عبر محاور الشبكة الدولية. في البيئات متعددة المشتركين، يدمج RiceGuard ميزة Threaded NAPI مع تقنيات توزيع الصفوف العتادية RSS وتسريع eBPF:
- تخصيص نوى الاستقبال: تُدار صفوف استقبال البطاقة بواسطة خيوط Threaded NAPI محكومة بسياسة
SCHED_FIFOعلى نوى مخصصة. - عزل خطوط التشفير: تعمل مسارات تشفير الحزم وتدقيقها عبر ChaCha20-Poly1305 على مصفوفة نوى منفصلة، منعزلة تمامًا عن مسار استلام البيانات.
- تنظيم الضغط العكسي بسلاسة: في حال امتلاء مخازن التشفير المؤقتة، تبطئ خيوط NAPI وتيرة الاستطلاع بمرونة دون إرباك نظام المقاطعات البرمجية العام، مما يحافظ على استمرارية تقنيات تجزئة النفق ومنع تسريب استعلامات DNS بكفاءة وموثوقية.


