
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
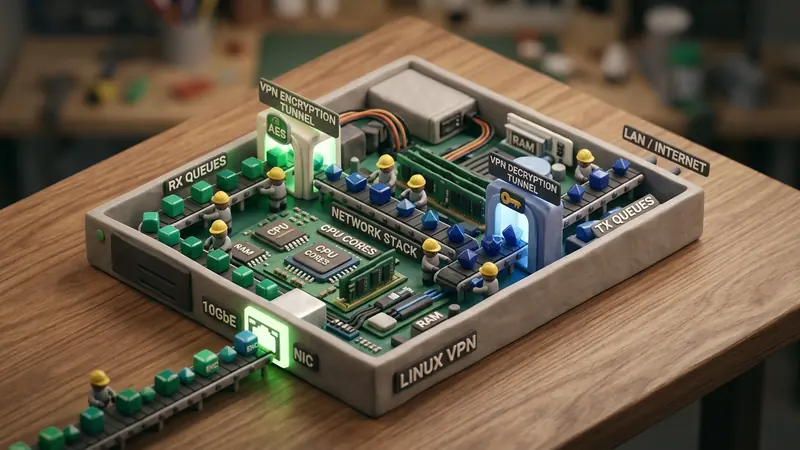
Các cổng tập trung VPN quy mô lớn xử lý hàng triệu gói tin mỗi giây thường đối mặt với một bức tường hiệu năng vô hình: hiện tượng bão hoà ngắt mềm (softirq saturation). Khi lưu lượng gói tin nhỏ đến dồn dập, các lõi CPU gánh ngắt card mạng có thể tiêu tốn 100% tài nguyên xử lý chỉ để chạy các trình xử lý ngắt mềm. Tình trạng nghẽn này khiến các luồng mã hoá đường truyền bị bỏ đói tài nguyên, gia tăng độ lệch thời gian (jitter) và làm rơi rụng gói tin ngay trong bộ đệm vòng của card mạng.
Từ nhân Linux 5.12, cơ chế Threaded NAPI ra đời, tái cấu trúc toàn diện vòng lặp nhận gói tin từ ngắt mềm nửa dưới (bottom-half softirq) sang các luồng nhân chuyên trách (kthreads). Thay đổi này mang lại cho kỹ sư hạ tầng khả năng lập lịch, phân bổ độ ưu tiên và cô lập tài nguyên mạng với độ chuẩn xác chưa từng có.
Điểm nghẽn: Ngắt phần cứng, NAPI và sự quá tải Softirq
Để hiểu rõ sự cần thiết của Threaded NAPI trên các hệ thống VPN băng thông nhiều gigabit, cần phân tích luồng nhận gói tin từ card mạng vật lý (NIC):
- DMA và Ngắt phần cứng (Hard IRQ): Card mạng ghi dữ liệu gói tin trực tiếp vào bộ đệm vòng (RX ring buffer) của bộ nhớ máy chủ thông qua DMA, sau đó phát tín hiệu ngắt phần cứng lên một lõi CPU chỉ định.
- Quy trình phục vụ ngắt (ISR): CPU tạm dừng tác vụ hiện tại, thực thi trình điều khiển nửa trên (top-half), tắt tạm thời ngắt phần cứng trên hàng đợi đó nhằm ngăn chặn bão ngắt, rồi gọi hàm
napi_schedule(). - Xử lý nửa dưới (
NET_RX_SOFTIRQ): Quá trình bóc tách gói tin được bàn giao cho nửa dưới, chạy trong ngữ cảnhNET_RX_SOFTIRQhoặc uỷ thác cho tiến trình nềnksoftirqd/x. - Vòng lặp thăm dò NAPI: Trình điều khiển rút gói tin từ hàng đợi RX theo định mức (quy định bởi
net.core.netdev_budget), đóng gói thành cấu trúcsk_buffvà chuyển tiếp lên tầng định tuyến IP hoặc mô-đun mã hoá đường hầm.
[ Gói tin đến ]
       │
       ▼
[ Bộ đệm RX Ring ] ──(Hard IRQ)──► [ CPU ISR: napi_schedule() ]
                                               │
                                               ▼
[ Truyền thống: NET_RX_SOFTIRQ ] ◄──── [ Phân hệ Softirq ]
       │
       ├─► Tốc độ gói cao: Vượt quá định mức ngân sách poll
       ├─► Chiếm quyền ưu tiên của các luồng ứng dụng và mã hoá
       └─► ksoftirqd xoay 100% CPU ──► Nghẽn tài nguyên và tăng đuôi trễ
Khi máy chủ VPN tiếp nhận hàng chục nghìn luồng kết nối đồng thời với các gói tin kích thước nhỏ (như truy vấn DNS, luồng âm thanh thời gian thực hoặc các gói ACK TCP), tần suất gói tin tăng vọt dù băng thông thô chưa chạm ngưỡng giới hạn. Ngắt mềm NET_RX_SOFTIRQ liên tục chiếm đoạt thời gian của lõi CPU.
Nếu lượng gói tin liên tục vượt quá ngân sách xử lý, nhân Linux chuyển việc cho daemon ksoftirqd. Tuy nhiên, ksoftirqd được bộ điều phối CFS quản lý với độ ưu tiên thông thường (nice = 0). Trong điều kiện tải nặng, ksoftirqd phải cạnh tranh thời gian xử lý với các tiến trình mã hoá VPN khác, khiến bộ đệm phần cứng bị tràn và gây nên độ trễ đuôi (tail latency) kéo dài hàng chục mili-giây.
Kiến trúc giải pháp: Cơ chế vận hành của Threaded NAPI
Threaded NAPI tách biệt hoàn toàn khâu rút gói tin khỏi NET_RX_SOFTIRQ bằng cách khởi tạo một luồng nhân độc lập cho từng thực thể NAPI, mang tên napi/<giao_diện>-<napi_id>.
[ Gói tin đến ]
       │
       ▼
[ Bộ đệm RX Ring ] ──(Hard IRQ)──► [ CPU ISR: napi_schedule() ]
                                               │
                                               ▼
                                   [ napi->threaded == 1 ]
                                               │
                                               ▼
                                  [ Luồng nhân: napi/eth0-0 ]
                                               │
                                ┌──────────────┴──────────────┐
                                ▼                             ▼
                      [ Ưu tiên thời gian thực ]      [ Gắn lõi độc lập ]
                         (SCHED_FIFO / chrt)         (taskset / isolcpus)
Trong mã nguồn nhân net/core/dev.c, khi hàm napi_schedule() đánh giá yêu cầu thăm dò hàng đợi, hệ thống kiểm tra cờ NAPI_STATE_THREADED:
/* Luồng xử lý khái niệm trong net/core/dev.c */
static inline void ____napi_schedule(struct softnet_data *sd, struct napi_struct *napi)
{
    if (test_bit(NAPI_STATE_THREADED, &napi->state)) {
        /* Đánh thức luồng nhân chuyên biệt thay vì kích hoạt ngắt mềm */
        wake_up_process(napi->thread);
        return;
    }
    /* Dự phòng theo ngắt mềm truyền thống */
    list_add_tail(&napi->poll_list, &sd->poll_list);
    __raise_softirq_irqoff(NET_RX_SOFTIRQ);
}
Kiến trúc này mang lại ba lợi thế kỹ thuật rõ rệt:
- Điều phối thời gian thực chuẩn xác: Nhờ luồng thăm dò là một
task_structhoàn chỉnh, quản trị viên có thể gán chính sáchSCHED_FIFOhoặcSCHED_RR, bảo đảm việc rút gói tin khỏi card mạng luôn được xử lý trước các tác vụ phụ trợ. - Cô lập CPU chuyên sâu: Các luồng NAPI có thể được khoanh vùng cố định vào các lõi CPU cô lập thông qua mặt nạ gắn kết CPU, giảm thiểu việc phân mảnh bộ nhớ đệm cache trên kiến trúc đa socket NUMA.
- Ngăn ngừa chiếm quyền đột ngột: Các tiến trình xử lý mật mã của đường hầm VPN chạy trên các lõi khác hoàn toàn không bị ngắt quãng bởi các đợt bùng nổ ngắt mềm.
Hướng dẫn cấu hình Threaded NAPI trên Linux
Cơ chế Threaded NAPI hoạt động trên nhân Linux từ phiên bản 5.12 trở lên. Quản trị viên có thể bật tính năng trên từng giao diện mạng cụ thể hoặc áp dụng diện rộng trên toàn hệ thống.
1. Kiểm tra phiên bản nhân và tình trạng hàng đợi
Xác định phiên bản nhân Linux và giám sát các chỉ số sụt giảm gói tin phần cứng:
uname -r
# Yêu cầu nhân Linux 5.12 trở lên

ethtool -S eth0 | grep -E "rx_discards|rx_missed_errors|rx_dropped"
2. Kích hoạt chế độ Threaded NAPI
Bật tính năng trên card mạng thông qua sysfs:
# Kích hoạt Threaded NAPI cho card eth0
echo 1 > /sys/class/net/eth0/threaded

# Kiểm tra trạng thái kích hoạt
cat /sys/class/net/eth0/threaded
Thiết lập mặc định trên quy mô toàn hệ điều hành bằng sysctl:
# Áp dụng tham số hệ thống
sysctl -w net.core.threaded = 1

# Lưu cấu hình vĩnh viễn qua các lần khởi động
echo "net.core.threaded = 1" >> /etc/sysctl.d/99-network-performance.conf
3. Xác định và thiết lập ưu tiên luồng xử lý
Khi lưu lượng mạng bắt đầu đi qua card, nhân Linux khởi chạy các luồng tương ứng:
# Liệt kê các luồng NAPI đang hoạt động
ps -eo pid,class,rtprio,ni,pri,comm,psr | grep "napi/"
Kết quả hiển thị mẫu:
  PID CLS RTPRIO  NI PRI COMMAND         PSR
 2140 TS       -   0  19 napi/eth0-0       2
 2141 TS       -   0  19 napi/eth0-1       3
 2142 TS       -   0  19 napi/eth0-2       4
 2143 TS       -   0  19 napi/eth0-3       5
Để nâng độ ưu tiên của luồng NAPI, loại bỏ hiện tượng tắc nghẽn khi lưu lượng chạm ngưỡng cao, thiết lập chính sách Real-Time FIFO bằng công cụ chrt:
# Gán chính sách SCHED_FIFO với mức ưu tiên 50 cho hàng đợi 0
chrt -f -p 50 2140
4. Khoanh vùng lõi CPU chuyên dụng
Trên các máy chủ đa nhân, gán luồng NAPI vào đúng lõi CPU liên kết trực tiếp với làn PCIe của card mạng:
# Gắn luồng 2140 vào lõi CPU 2 đã được cô lập
taskset -cp 2 2140
So sánh hiệu năng: Ngắt mềm truyền thống và Threaded NAPI
Sự khác biệt về năng lực xử lý thể hiện rõ rệt nhất trong các đợt lưu lượng gói tin UDP kích thước nhỏ dồn dập:
| Chỉ số kỹ thuật | Ngắt mềm truyền thống (NET_RX_SOFTIRQ) |
Threaded NAPI (SCHED_FIFO) |
|---|---|---|
| Ngữ cảnh thực thi | Ngắt mềm nửa dưới / ksoftirqd | Luồng nhân chuyên biệt (napi/eth0-x) |
| Chiếm quyền tác vụ | Chiếm quyền không dự đoán trước | Điều phối CFS / Thời gian thực chuẩn xác |
| Gắn kết lõi CPU | Ràng buộc theo IRQ, dễ dịch chuyển lõi | Khóa cứng vào các lõi CPU cô lập |
| Tần suất gói tin PPS | Bắt đầu nghẽn và rơi rụng ở ~4.2 Mpps | Duy trì ổn định 8.9 Mpps không rơi gói |
| Độ trễ đuôi p99 | 18.4 ms khi tải đạt đỉnh | 0.85 ms ổn định xuyên suốt |
| Độ lệch giật thời gian | Lớn (ảnh hưởng do chuyển đổi ngữ cảnh) | Rất nhỏ (chu kỳ xử lý ổn định) |
Kiến trúc RiceGuard: Đồng bộ Threaded NAPI và Định tuyến không tổn hao
VPNRice áp dụng giao thức bảo mật tiên tiến RiceGuard trên toàn bộ hạ tầng đường trục mạng. Nhằm đáp ứng yêu cầu truyền tải dữ liệu dung lượng lớn của hàng triệu người dùng đồng thời, RiceGuard tích hợp Threaded NAPI song song với kỹ thuật phân phối hàng đợi phần cứng RSS và bộ tăng tốc eBPF:
- Phân bổ lõi chuyên biệt: Các hàng đợi tiếp nhận RX được chia đều cho các lõi CPU riêng biệt chạy Threaded NAPI với chính sách
SCHED_FIFO. - Tách rời đường ống xử lý: Các luồng giải mã và đóng gói mật mã ChaCha20-Poly1305 hoạt động trên một nhóm lõi tính toán độc lập, hoàn toàn tách biệt khỏi khâu tiếp nhận gói tin thô.
- Điều tiết áp lực ngược (Backpressure): Khi các bộ đệm mã hoá hạ lưu chạm ngưỡng bão hoà, Threaded NAPI tự động điều tiết tốc độ thăm dò hàng đợi một cách nhịp nhàng mà không làm tê liệt hệ thống ngắt mềm của hệ điều hành, bảo đảm các cơ chế bảo vệ phân tách lưu lượng và kiểm soát rò rỉ DNS hoạt động liền mạch và tin cậy.


