
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
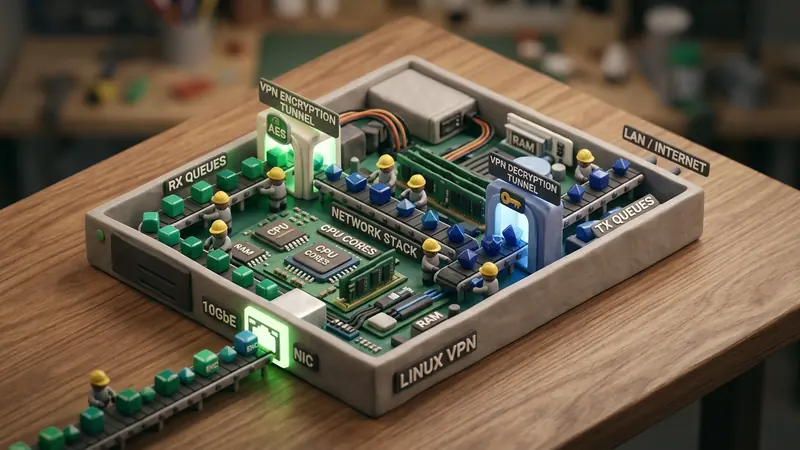
Высоконагруженные VPN-шлюзы, обрабатывающие миллионы пакетов в секунду, регулярно сталкиваются со скрытым барьером производительности: насыщением программных прерываний (softirq). При интенсивном входящем трафике процессорные ядра, обслуживающие прерывания сетевой карты, тратят почти весь вычислительный бюджет на обработчики прерываний. Возникающий дефицит ресурсов замедляет потоки криптографической обработки, вызывает скачки джиттера и приводит к потере пакетов в аппаратных кольцевых буферах.
В ядре Linux 5.12 появился механизм Threaded NAPI, который кардинально изменил архитектуру опроса сетевых очередей, перенеся обработку из прерываний softirq в выделенные потоки ядра (kthreads). Это нововведение предоставило системным инженерам возможность планировать, приоритизировать и изолировать сетевой трафик с высокой точностью.
Проблема: Аппаратные прерывания, NAPI и перегрузка Softirq
Чтобы оценить значение Threaded NAPI в производительных узлах VPN, рассмотрим классическую модель приема пакетов в сетевом стеке Linux:
- Передача DMA и аппаратное прерывание (Hard IRQ): Сетевой адаптер (NIC) записывает входящие пакеты в кольцевой буфер оперативной памяти через DMA и подает аппаратный сигнал прерывания на назначенное процессорное ядро.
- Обработчик прерывания (ISR): Процессор приостанавливает текущую задачу, выполняет верхнюю половину драйвера (top-half), временно отключает аппаратные прерывания на данной очереди для защиты от шторма прерываний и вызывает
napi_schedule(). - Нижняя половина обработки (
NET_RX_SOFTIRQ): Извлечение пакетов передается нижней половине, выполняемой в контекстеNET_RX_SOFTIRQлибо фоновым демономksoftirqd/x. - Цикл опроса NAPI: Драйвер считывает пакеты из очереди в пределах заданного лимита (параметр
net.core.netdev_budget), упаковывает их в структурыsk_buffи передает подсистеме маршрутизации или шифрования.
[ Входящие пакеты ]
         │
         ▼
[ Буфер RX Ring ] ──(Hard IRQ)──► [ Процессорный ISR: napi_schedule() ]
                                                 │
                                                 ▼
[ Классический режим: NET_RX_SOFTIRQ ] ◄── [ Подсистема Softirq ]
         │
         ├─► Высокая частота пакетов: Превышение бюджета опроса
         ├─► Вытеснение прикладных и криптографических потоков
         └─► ksoftirqd загружает ядро на 100% ──► Дефицит ресурсов и задержки
Когда VPN-шлюз обслуживает множество защищенных туннелей с пакетами малого размера (запросы DNS, голосовой трафик RTP, подтверждения TCP ACK), интенсивность пакетов резко возрастает даже при умеренной общей полосе пропускания. Контекст NET_RX_SOFTIRQ монополизирует ресурсы вычислительного ядра.
Если поток пакетов стабильно превышает бюджет, ядро переключает задачу на ksoftirqd. Однако планировщик CFS выделяет процессорное время демону ksoftirqd со стандартным приоритетом (nice = 0). При высокой нагрузке ksoftirqd конкурирует с другими процессами, что приводит к переполнению буферов сетевой карты и скачкам хвостовой задержки (tail latency) до десятков миллисекунд.
Архитектура Threaded NAPI: Принцип работы
Механизм Threaded NAPI отделяет извлечение пакетов от подсистемы NET_RX_SOFTIRQ, создавая для каждого экземпляра NAPI персональный поток ядра с именем napi/<интерфейс>-<napi_id>.
[ Входящие пакеты ]
         │
         ▼
[ Буфер RX Ring ] ──(Hard IRQ)──► [ Процессорный ISR: napi_schedule() ]
                                                 │
                                                 ▼
                                     [ napi->threaded == 1 ]
                                                 │
                                                 ▼
                                     [ Поток ядра: napi/eth0-0 ]
                                                 │
                                ┌────────────────┴────────────────┐
                                ▼                                 ▼
                     [ Приоритет реального времени ]     [ Привязка к ядру ]
                           (SCHED_FIFO / chrt)          (taskset / isolcpus)
В исходном коде ядра (net/core/dev.c), когда функция napi_schedule() обрабатывает запрос на опрос, проверяется флаг активации многопоточного режима:
/* Концептуальная схема работы в net/core/dev.c */
static inline void ____napi_schedule(struct softnet_data *sd, struct napi_struct *napi)
{
    if (test_bit(NAPI_STATE_THREADED, &napi->state)) {
        /* Пробуждение персонального потока ядра без вызова softirq */
        wake_up_process(napi->thread);
        return;
    }
    /* Переход на классический механизм программных прерываний */
    list_add_tail(&napi->poll_list, &sd->poll_list);
    __raise_softirq_irqoff(NET_RX_SOFTIRQ);
}
Такое разделение предоставляет системным администраторам три ключевых преимущества:
- Предсказуемое диспетчирование реального времени: Поток NAPI представляет собой стандартную структуру
task_struct, что позволяет назначить ему дисциплинуSCHED_FIFOилиSCHED_RRдля гарантированной обработки трафика без задержек. - Изоляция вычислительных ядер: Потоки NAPI можно закрепить за определенными изолированными ядрами процессора с помощью масок сродства (affinity), предотвращая миграцию данных между узлами памяти NUMA.
- Устранение нежелательного вытеснения: Криптографические потоки VPN, работающие на соседних ядрах, защищены от спонтанных прерываний, вызванных всплесками сетевого трафика.
Практическая настройка Threaded NAPI в Linux
Для использования Threaded NAPI требуется версия ядра Linux 5.12 или новее. Конфигурацию можно активировать точечно для выбранного интерфейса либо глобально для всей системы.
1. Проверка версии ядра и счетчиков сброса пакетов
Убедитесь в поддержке механизмов ядром и проверьте текущее состояние очередей:
uname -r
# Требуется ядро версии 5.12 или выше

ethtool -S eth0 | grep -E "rx_discards|rx_missed_errors|rx_dropped"
2. Включение многопоточного режима NAPI
Активируйте режим через виртуальную файловую систему sysfs:
# Включение Threaded NAPI для интерфейса eth0
echo 1 > /sys/class/net/eth0/threaded

# Проверка текущего статуса
cat /sys/class/net/eth0/threaded
Для установки многопоточного режима по умолчанию на уровне всего сервера воспользуйтесь sysctl:
# Применение системного параметра
sysctl -w net.core.threaded = 1

# Сохранение конфигурации между перезагрузками
echo "net.core.threaded = 1" >> /etc/sysctl.d/99-network-performance.conf
3. Обнаружение и приоритизация потоков NAPI
После появления входящего трафика ядро регистрирует соответствующие потоки:
# Поиск активных потоков NAPI
ps -eo pid,class,rtprio,ni,pri,comm,psr | grep "napi/"
Пример вывода:
  PID CLS RTPRIO  NI PRI COMMAND         PSR
 2140 TS       -   0  19 napi/eth0-0       2
 2141 TS       -   0  19 napi/eth0-1       3
 2142 TS       -   0  19 napi/eth0-2       4
 2143 TS       -   0  19 napi/eth0-3       5
Чтобы повысить приоритет потока NAPI и исключить задержки при максимальной нагрузке, установите политику реального времени FIFO с помощью утилиты chrt:
# Назначение SCHED_FIFO с приоритетом 50 для очереди 0
chrt -f -p 50 2140
4. Фиксация потоков за выделенными процессорными ядрами
На многопроцессорных платформах закрепите потоки NAPI за ядрами, физически связанными с шиной PCIe сетевого адаптера:
# Привязка потока 2140 к изолированному ядру 2
taskset -cp 2 2140
Сравнение характеристик: Традиционный Softirq и Threaded NAPI
Эффект от внедрения Threaded NAPI наиболее заметен при непрерывном потоке мелких пакетов UDP, характерных для инкапсулированного туннельного трафика:
| Параметр | Традиционный Softirq (NET_RX_SOFTIRQ) |
Threaded NAPI (SCHED_FIFO) |
|---|---|---|
| Контекст исполнения | Нижняя половина прерывания / ksoftirqd | Выделенный поток ядра (napi/eth0-x) |
| Характер вытеснения | Неконтролируемое вытеснение пользовательских задач | Предсказуемое диспетчирование реального времени |
| Привязка к ядрам | Привязана к IRQ, склонна к миграции | Жестко зафиксирована на изолированных ядрах |
| Производительность PPS | Потери начинаются при ~4.2 Mpps | Стабильная обработка 8.9 Mpps без потерь |
| Хвостовая задержка p99 | 18.4 мс при максимальной загрузке | 0.85 мс на постоянном уровне |
| Флуктуация джиттера | Высокая из-за переключения контекстов | Минимальная благодаря стабильным интервалам |
Архитектура RiceGuard: Надежная маршрутизация без потерь
Платформа VPNRice применяет архитектуру RiceGuard для эффективной передачи зашифрованного трафика на магистральных каналах. В условиях высокой плотности подключений RiceGuard сочетает Threaded NAPI с аппаратным распределением очередей RSS и фильтрацией eBPF:
- Выделение отдельных ядер: Аппаратные очереди сетевой карты обрабатываются на изолированных ядрах процессора с помощью Threaded NAPI под управлением
SCHED_FIFO. - Разделение конвейеров обработки: Операции шифрования ChaCha20-Poly1305 выполняются на отдельном пуле ядер, полностью изолированном от этапа приема сетевых пакетов.
- Плавная регулировка давления (Backpressure): Если буферы шифрования заполняются, Threaded NAPI плавно замедляет извлечение пакетов без блокировки системных прерываний ядра. Это гарантирует бесперебойную работу механизмов раздельного туннелирования и защиту от утечек DNS.


