
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
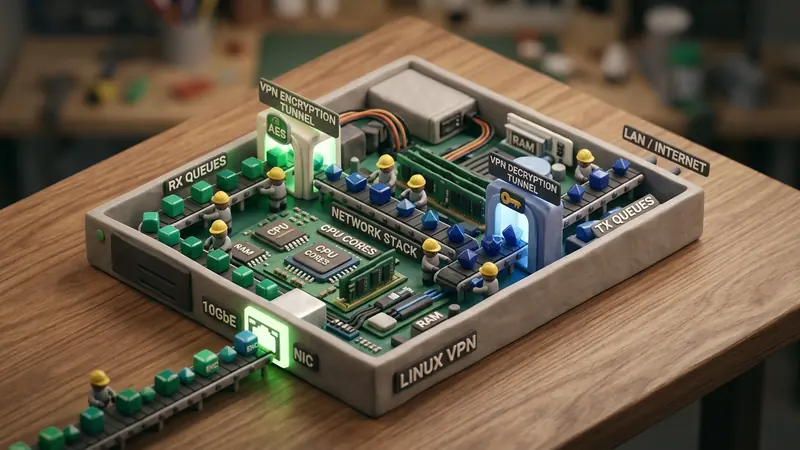
在每秒需要处理数百万数据包的高吞吐 VPN 集中网关上,网络工程师常会遭遇一道难以察觉的性能瓶颈:软中断(softirq)资源饱和。当高密度的微小数据包涌入网络接口时,负责响应网卡硬件中断的 CPU 核心可能将几乎全部计算周期消耗在软中断处理程序中。这种 CPU 饥饿现象会严重挤占隧道加密工作线程的调度时间,引发抖动,并在网卡硬件环形缓冲区(Ring Buffer)中造成隐蔽的丢包。
Linux 5.12 正式引入了 Threaded NAPI 机制,从底层重构了数据包轮询模型,将处理逻辑由底半部(bottom-half)软中断迁移至专属内核线程(kthreads)。这一技术演进为网络系统管理人员提供了精准调度、设定优先级和隔离网络负载的全新途径。
性能瓶颈:硬件中断、NAPI 与软中断饱和
要理解 Threaded NAPI 在千兆及多吉比特 VPN 节点中的核心价值,必须厘清 Linux 内核从物理网卡接收数据包的完整流程:
- DMA 传输与硬件中断(Hard IRQ):物理网卡(NIC)通过直接内存访问(DMA)将接收到的数据包写入主机内存的环形接收缓冲区(RX Ring Buffer),随后向指定 CPU 核心触发硬件中断信号。
- 中断服务例程(ISR):CPU 暂停当前任务,执行网卡驱动顶半部(top-half)中断处理程序,临时关闭该接收队列的硬件中断以避免中断风暴,并调用
napi_schedule()。 - 底半部处理(
NET_RX_SOFTIRQ):数据包提取逻辑转交底半部,传统架构下在NET_RX_SOFTIRQ软中断上下文中执行,或交由内核守护进程ksoftirqd/x运转。 - NAPI 轮询循环:驱动轮询例程根据预设预算额度(由
net.core.netdev_budget约束)从 RX 环形队列批量抓取数据包,封装为sk_buff结构,并递交至 IP 路由子系统或加密层。
[ 入站数据包流 ]
        │
        ▼
[ 网卡 RX 环形队列 ] ──(硬件中断)──► [ CPU ISR 例程:napi_schedule() ]
                                                 │
                                                 ▼
[ 传统模式:NET_RX_SOFTIRQ ] ◄────────── [ 软中断子系统 ]
        │
        ├─► 高包率冲击:迅速耗尽轮询预算额度
        ├─► 频繁抢占用户态守护进程与加密线程
        └─► ksoftirqd 耗尽单核 CPU 周期 ──► 计算资源饥饿与尾部延迟剧增
当 VPN 网关同时承载数以万计并发连接且主要流经小数据包(如 DNS 解析、即时语音 RTP 流或 TCP ACK 控制包)时,即使总带宽吞吐尚未饱和,数据包到达频率(PPS)也会成倍攀升。NET_RX_SOFTIRQ 软中断将长时间独占 CPU 核心。
一旦数据包产生速率持续超出处理预算,内核将任务转交给 ksoftirqd 处理。然而,ksoftirqd 由完全公平调度器(CFS)以默认普通优先级(nice = 0)进行分配。在重载工况下,ksoftirqd 无法及时获得足够的 CPU 执行切片,直接导致网卡硬件队列溢出,端到端尾部延迟可飙升至数十毫秒。
架构演进:Threaded NAPI 工作机制
Threaded NAPI 将数据包接收工作彻底与 NET_RX_SOFTIRQ 解耦,为每个 NAPI 实例独立派生专属内核线程,其进程命名规则为 napi/<网卡名>-<napi_id>。
[ 入站数据包流 ]
        │
        ▼
[ 网卡 RX 环形队列 ] ──(硬件中断)──► [ CPU ISR 例程:napi_schedule() ]
                                                 │
                                                 ▼
                                     [ napi->threaded == 1 ]
                                                 │
                                                 ▼
                                    [ 内核线程:napi/eth0-0 ]
                                                 │
                                ┌────────────────┴────────────────┐
                                ▼                                 ▼
                       [ 实时调度优先级 ]                 [ 独立核心亲和性绑定 ]
                      (SCHED_FIFO / chrt)                (taskset / isolcpus)
在内核源码 net/core/dev.c 中,当 napi_schedule() 收到轮询触发请求时,会先检测 NAPI 对象的线程化标记:
/* net/core/dev.c 内部概念流程 */
static inline void ____napi_schedule(struct softnet_data *sd, struct napi_struct *napi)
{
    if (test_bit(NAPI_STATE_THREADED, &napi->state)) {
        /* 唤醒专用内核线程,不触发软中断 */
        wake_up_process(napi->thread);
        return;
    }
    /* 回退至传统软中断机制 */
    list_add_tail(&napi->poll_list, &sd->poll_list);
    __raise_softirq_irqoff(NET_RX_SOFTIRQ);
}
这种机制确立了三大技术优势:
- 确定性实时调度保障:由于轮询实体转变为标准
task_struct线程,运维人员可为其赋予SCHED_FIFO或SCHED_RR实时调度策略,确保网卡收包处理不会被普通系统任务阻塞。 - 物理核心隔离与局部性维护:专属 NAPI 线程可通过 CPU 亲和性掩码绑定至指定计算核心,消除多插槽 NUMA 架构下跨核心调度引起的缓存失效损耗。
- 规避突发中断抢占:在其他计算核心上运行的 VPN 隧道加解密任务与用户态程序,彻底免受软中断风暴的无序干扰。
在 Linux 环境中配置与调优 Threaded NAPI
启用 Threaded NAPI 要求系统运行 Linux 5.12 或更新版本内核。既可针对单张网卡独立配置,也可全局统一开启。
1. 内核版本与丢包指标核对
首先确认内核版本并检查现有接口的硬件丢包情况:
uname -r
# 确认内核版本处于 5.12 及以上

ethtool -S eth0 | grep -E "rx_discards|rx_missed_errors|rx_dropped"
2. 开启 Threaded 模式
针对目标网卡接口开启线程化模式:
# 通过 sysfs 针对 eth0 启用 Threaded NAPI
echo 1 > /sys/class/net/eth0/threaded

# 验证当前工作状态
cat /sys/class/net/eth0/threaded
若需在全系统范围内设为默认选项,可使用 sysctl 进行全局部署:
# 全局启用线程化 NAPI
sysctl -w net.core.threaded = 1

# 写入配置文件以确保重启后依然生效
echo "net.core.threaded = 1" >> /etc/sysctl.d/99-network-performance.conf
3. 定位并调优 NAPI 内核线程优先级
当网络流量穿过网卡时,内核将动态初始化对应的轮询线程:
# 查看正在运行的 NAPI 线程
ps -eo pid,class,rtprio,ni,pri,comm,psr | grep "napi/"
终端输出示例:
  PID CLS RTPRIO  NI PRI COMMAND         PSR
 2140 TS       -   0  19 napi/eth0-0       2
 2141 TS       -   0  19 napi/eth0-1       3
 2142 TS       -   0  19 napi/eth0-2       4
 2143 TS       -   0  19 napi/eth0-3       5
为了确保数据包在高负荷状态下得到即时处理,使用 chrt 工具赋予其实时 FIFO 调度优先级:
# 将队列 0 对应的 NAPI 线程设为 SCHED_FIFO 策略,优先级设为 50
chrt -f -p 50 2140
4. 绑定专属 CPU 核心
在多核心高性能服务器上,将 NAPI 线程绑定至与物理网卡 PCIe 通道同属一个 NUMA 节点的隔离核心:
# 将线程 2140 绑定至预先隔离的 CPU 核心 2
taskset -cp 2 2140
性能基准对比:传统模式与 Threaded NAPI
在高并发小包数据冲击下,Threaded NAPI 展现出显著的吞吐与延迟稳定性优势:
| 指标维度 | 传统软中断模式 (NET_RX_SOFTIRQ) |
Threaded NAPI 模式 (SCHED_FIFO) |
|---|---|---|
| 执行上下文 | 底半部中断 / ksoftirqd | 专用内核线程 (napi/eth0-x) |
| 任务抢占表现 | 随机抢占业务进程造成执行间隙 | 可控的实时优先级确定性调度 |
| 核心亲和力 | 随中断漂移,缓存局部性弱 | 严格锁定至专属隔离核心 |
| 小包吞吐承载 | 超过 ~4.2 Mpps 即出现缓冲区丢包 | 持续稳定承载 8.9 Mpps 且零硬件丢包 |
| p99 尾部延迟 | 高峰负载下攀升至 18.4 ms | 持续保持在 0.85 ms 极低水平 |
| 抖动稳定性 | 较高(频繁上下文切换损耗) | 极低(处理窗口平稳有序) |
RiceGuard 架构落地:协同构建低损耗路由矩阵
VPNRice 基于自研的 RiceGuard 网络框架支撑大规模跨境加密通信基础设施。在高密度多租户运行环境下,RiceGuard 将 Threaded NAPI 与多队列接收端扩展(RSS)及 eBPF 快速通道技术有机融合:
- 专用收包核心群组:网卡硬件 RX 队列由绑定了
SCHED_FIFO实时策略的 Threaded NAPI 线程集中接管,运转于专属 I/O 核心之上。 - 解耦加解密流水线:ChaCha20-Poly1305 数据加密与校验例程交由独立的计算核心池执行,彻底与底层收包流水线解耦。
- 弹性反压控制机制:当下游加密队列达到暂态上限时,Threaded NAPI 平稳调节轮询速率,绝不拖垮操作系统软中断子系统,确保分流策略与 DNS 防泄漏保护机制持续稳健运转。


