
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
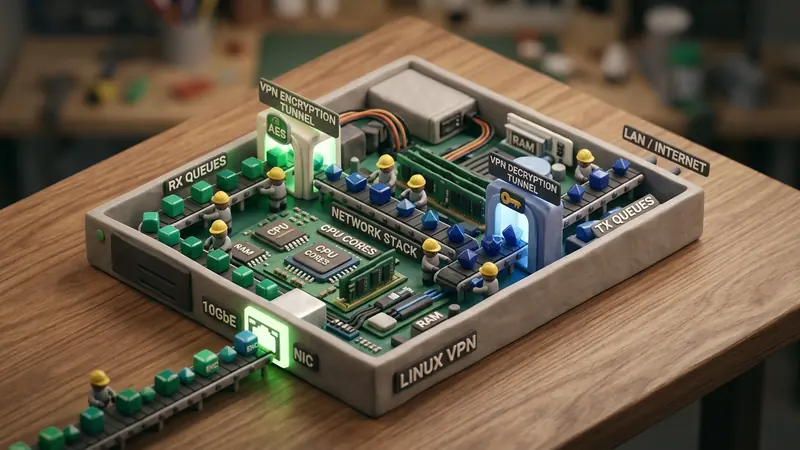
Високонавантажені шлюзи VPN, які обробляють мільйони пакетів щосекунди, регулярно стикаються з невидимим бар'єром продуктивності: насиченням програмних переривань (softirq). За умов інтенсивного вхідного трафіку процесорні ядра, що обслуговують переривання мережевої карти, витрачають практично весь робочий час на обробники переривань. Виникаючий дефіцит обчислювальних ресурсів уповільнює потоки криптографічної обробки, спричиняє коливання джиттера та призводить до втрати пакетів у кільцевих буферах мережевого адаптера.
Починаючи з версії Linux 5.12, механізм Threaded NAPI докорінно трансформував процес опитування мережевих черг, перенісши обробку з переривань softirq у виділені потоки ядра (kthreads). Це нововведення надало системним інженерам можливість планувати, призначати пріоритети та ізолювати мережевий трафік із максимальною точністю.
Вузьке місце: Апаратні переривання, NAPI та насичення Softirq
Щоб оцінити практичну користь Threaded NAPI у продуктивних вузлах VPN, розглянемо класичний шлях отримання пакетів у мережевому стеку Linux:
- Передача DMA та апаратне переривання (Hard IRQ): Мережевий адаптер (NIC) записує вхідні пакети в кільцевий буфер оперативної пам'яті за допомогою DMA і генерує апаратний сигнал переривання на призначене процесорне ядро.
- Процедура обслуговування переривання (ISR): Процесор тимчасово зупиняє поточне завдання, виконує верхню частину драйвера (top-half), вимикає апаратні переривання на цій черзі для захисту від шторму переривань і викликає
napi_schedule(). - Нижня частина обробки (
NET_RX_SOFTIRQ): Вилучення пакетів передається нижній частині, яка традиційно виконується в контекстіNET_RX_SOFTIRQабо фоновим процесомksoftirqd/x. - Цикл опитування NAPI: Драйвер зчитує пакети з черги у межах визначеного ліміту (параметр
net.core.netdev_budget), пакує їх у структуриsk_buffта передає підсистемі маршрутизації IP або модулям шифрування тунелю.
[ Вхідні пакети ]
        │
        ▼
[ Кільцевий буфер RX ] ──(Hard IRQ)──► [ Процесорний ISR: napi_schedule() ]
                                                    │
                                                    ▼
[ Традиційний режим: NET_RX_SOFTIRQ ] ◄──── [ Підсистема Softirq ]
        │
        ├─► Висока частота пакетів: Перевищення бюджету опитування
        ├─► Витіснення прикладних і криптографічних потоків
        └─► ksoftirqd завантажує ядро на 100% ──► Дефіцит ресурсів і затримки
Коли шлюз VPN обслуговує велику кількість одночасних тунелів із пакетами малого розміру (запити DNS, голосовий трафік RTP або пакети підтвердження TCP ACK), частота пакетів стрімко зростає навіть за помірної загальної пропускної здатності. Контекст NET_RX_SOFTIRQ повністю монополізує процесорне ядро.
Якщо потік пакетів стабільно перевищує бюджет, ядро перемикає виконання на ksoftirqd. Проте планувальник CFS надає процесорний час демону ksoftirqd зі звичайним пріоритетом (nice = 0). За умов високого навантаження ksoftirqd конкурує з іншими завданнями, що призводить до переповнення буферів мережевої карти та зростання хвостової затримки (tail latency) до десятків мілісекунд.
Архітектура Threaded NAPI: Принцип функціонування
Механізм Threaded NAPI відокремлює отримання пакетів від підсистеми NET_RX_SOFTIRQ, створюючи для кожного екземпляра NAPI персональний потік ядра з назвою napi/<інтерфейс>-<napi_id>.
[ Вхідні пакети ]
        │
        ▼
[ Кільцевий буфер RX ] ──(Hard IRQ)──► [ Процесорний ISR: napi_schedule() ]
                                                    │
                                                    ▼
                                        [ napi->threaded == 1 ]
                                                    │
                                                    ▼
                                       [ Потік ядра: napi/eth0-0 ]
                                                    │
                                ┌───────────────────┴───────────────────┐
                                ▼                                       ▼
                    [ Пріоритет реального часу ]             [ Прив'язка до ядра ]
                        (SCHED_FIFO / chrt)                 (taskset / isolcpus)
У вихідному коді ядра (net/core/dev.c), коли функція napi_schedule() аналізує запит на опитування, перевіряється наявність увімкненого багатопотокового режиму:
/* Концептуальна схема роботи в net/core/dev.c */
static inline void ____napi_schedule(struct softnet_data *sd, struct napi_struct *napi)
{
    if (test_bit(NAPI_STATE_THREADED, &napi->state)) {
        /* Пробудження виділеного потоку ядра без запуску softirq */
        wake_up_process(napi->thread);
        return;
    }
    /* Перехід до класичного механізму програмних переривань */
    list_add_tail(&napi->poll_list, &sd->poll_list);
    __raise_softirq_irqoff(NET_RX_SOFTIRQ);
}
Такий підхід забезпечує три вагомі переваги:
- Передбачуване планування реального часу: Потік NAPI є стандартною структурою
task_struct, що дозволяє призначити йому дисциплінуSCHED_FIFOабоSCHED_RRдля своєчасної обробки черг без простоїв. - Ізоляція обчислювальних ядер: Потоки NAPI можна зафіксувати на спеціально ізольованих процесорних ядрах за допомогою масок спорідненості (affinity), запобігаючи втратам продуктивності через міграцію кешу в архітектурі NUMA.
- Захист від раптового витіснення: Криптографічні потоки тунелів VPN, запущені на сусідніх ядрах, повністю захищені від раптових сплесків програмних переривань.
Налаштування Threaded NAPI у середовищі Linux
Для роботи Threaded NAPI потрібне ядро Linux версії 5.12 або новіше. Конфігурацію можна активувати для окремого мережевого інтерфейсу або на рівні всієї операційної системи.
1. Перевірка версії ядра та діагностика скидання пакетів
Перевірте версію системи та перегляньте статистику втрат пакетів на мережевому адаптері:
uname -r
# Потрібна версія ядра 5.12 або вища

ethtool -S eth0 | grep -E "rx_discards|rx_missed_errors|rx_dropped"
2. Активація режиму Threaded NAPI
Увімкніть багатопотоковий режим для інтерфейсу через sysfs:
# Активація для інтерфейсу eth0
echo 1 > /sys/class/net/eth0/threaded

# Перевірка поточного стану
cat /sys/class/net/eth0/threaded
Для застосування режиму за замовчуванням на рівні всієї системи скористайтеся sysctl:
# Встановлення глобального параметра
sysctl -w net.core.threaded = 1

# Збереження налаштувань між перезавантаженнями
echo "net.core.threaded = 1" >> /etc/sysctl.d/99-network-performance.conf
3. Виявлення та налаштування пріоритетів потоків NAPI
Після надходження трафіку ядро автоматично створює відповідні системні потоки:
# Пошук активних потоків NAPI
ps -eo pid,class,rtprio,ni,pri,comm,psr | grep "napi/"
Приклад виведення:
  PID CLS RTPRIO  NI PRI COMMAND         PSR
 2140 TS       -   0  19 napi/eth0-0       2
 2141 TS       -   0  19 napi/eth0-1       3
 2142 TS       -   0  19 napi/eth0-2       4
 2143 TS       -   0  19 napi/eth0-3       5
Щоб підвищити пріоритет потоку NAPI й уникнути накопичення черги за пікового трафіку, призначте політику реального часу FIFO за допомогою утиліти chrt:
# Призначення SCHED_FIFO з пріоритетом 50 для черги 0
chrt -f -p 50 2140
4. Закріплення потоків за ізольованими ядрами
На багатопроцесорних серверах призначте потоки NAPI до ядер, які мають прямий фізичний зв'язок із шиною PCIe мережевого адаптера:
# Прив'язка потоку 2140 до ізольованого ядра 2
taskset -cp 2 2140
Порівняння продуктивності: Традиційний Softirq та Threaded NAPI
Переваги Threaded NAPI виявляються найпомітнішими під час інтенсивних сплесків невеликих пакетів UDP, типових для зашифрованого тунельного трафіку:
| Показник | Традиційний Softirq (NET_RX_SOFTIRQ) |
Threaded NAPI (SCHED_FIFO) |
|---|---|---|
| Контекст виконання | Нижня частина переривання / ksoftirqd | Виділений потік ядра (napi/eth0-x) |
| Поведінка витіснення | Неконтрольоване переривання завдань користувача | Чітке планування реального часу |
| Прив'язка до ядер | Залежить від IRQ, схильна до міграцій | Жорстко зафіксована на ізольованих ядрах |
| Частота пакетів PPS | Втрати починаються приблизно з ~4.2 Mpps | Стабільне оброблення 8.9 Mpps без втрат |
| Хвостова затримка p99 | 18.4 мс під час пікового навантаження | 0.85 мс стабільно за будь-яких умов |
| Варіація джиттера | Висока через постійні зміни контексту | Мінімальна завдяки рівномірним циклам |
Архітектура RiceGuard: Надійне тунелювання без втрат
Платформа VPNRice використовує протокол RiceGuard для надійного передавання зашифрованих даних через магістральні вузли. У середовищі з високою щільністю підключень RiceGuard поєднує Threaded NAPI з апаратним розподілом черг RSS та прискоренням eBPF:
- Виділення ресурсів ядер: Черги прийому RX обробляються на виділених ядрах процесора за допомогою Threaded NAPI під керуванням
SCHED_FIFO. - Розмежування криптографічних процесів: Операції шифрування ChaCha20-Poly1305 виконуються на окремому пулі обчислювальних ядер, повністю ізольованому від черги прийому пакетів.
- Плавне керування навантаженням (Backpressure): Якщо криптографічні буфери переповнюються, Threaded NAPI адаптивно регулює темп опитування черг без блокування системних переривань ядра, забезпечуючи стабільну роботу роздільного тунелювання та механізмів захисту від витоків DNS.


