
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
La mise en place d'un routage sélectif par application (split tunneling) sous Linux a longtemps représenté un compromis complexe pour les administrateurs réseau. Les postes de travail en entreprise doivent acheminer les flux sensibles, les consoles de développement et les navigateurs sécurisés à travers un tunnel chiffré WireGuard, tout en permettant aux flux multimédias ou aux transferts locaux de sortir directement sur l'interface WAN afin de préserver les performances.
Les méthodes traditionnelles reposent sur le filtrage paquet par paquet : marquage Netfilter iptables/nftables par identifiant utilisateur (skuid), routage conditionnel (fwmark), ou isolation au sein d'espaces de noms réseau (ip netns). Chacun de ces mécanismes historiques impose une charge de calcul continue : Netfilter inspecte chaque entête, gère la table d'états nf_conntrack et consulte des tables de routage supplémentaires. De leur côté, les espaces de noms réseau isolent complètement les communications inter-processus (IPC), brisant l'affichage Wayland et le serveur audio PipeWire.
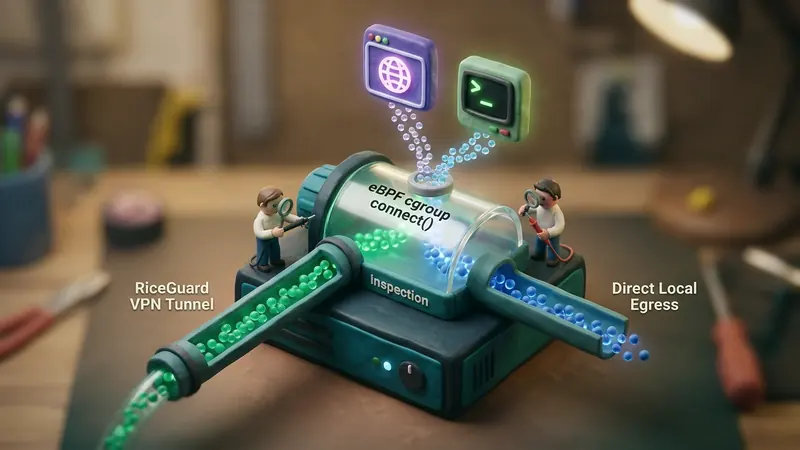
L'introduction du type de programme BPF_PROG_TYPE_CGROUP_SOCK_ADDR dans le noyau Linux redéfinit totalement cette gestion. En rattachant la logique eBPF directement aux points d'ancrage des sockets cgroup (connect, sendmsg et recvmsg), la décision de routage s'opère instantanément à la frontière de l'appel système. Les paquets ne subissent aucune inspection répétée : la socket elle-même est orientée et configurée lors de son initialisation, offrant un fractionnement du trafic à vitesse nominale.
Comparaison des architectures de Split Tunneling sous Linux :

Modèle classique Netfilter / Marquage de paquets :
Application ──> send() ──> Création sk_buff ──> Netfilter PREROUTING ──> Filtre UID ──> fwmark
  ──> Recherche table de routage ──> Tunnel (Répété sur chaque paquet)

Modèle eBPF Connect-Time (BPF_PROG_TYPE_CGROUP_SOCK_ADDR) :
Application ──> connect() ──> Crochet eBPF (cgroup) ──> Réécriture destination / Assignation IP
  ──> Routage natif du noyau ──> Socket établie ──> Débit maximal sans inspection continue
Limites structurelles des méthodes conventionnelles
Pour saisir la portée de l'approche eBPF, examinons les mécanismes traditionnels déployés jusqu'ici :
1. Filtrage UID/GID et Fwmark via Netfilter
L'approche la plus fréquente associe les paquets émis par un compte système à une table de routage spécifique :
# Marquage des paquets émis par un groupe système dédié
iptables -t mangle -A OUTPUT -m owner --gid-owner vpn-routed -j MARK --set-mark 0x100
ip rule add fwmark 0x100 table 200
ip route add default dev wg0 table 200
Bien que fonctionnelle, cette approche présente des inconvénients majeurs à fort volume :
- Consommation CPU par paquet : Chaque paquet transmis requiert l'évaluation des règles Netfilter et la consultation des tables. Sur des interfaces 10 GbE ou 40 GbE, le processeur sature rapidement.
- Incompatibilité avec les conteneurs et les démons partagés : Les applications partageant le même UID utilisateur ne peuvent être distinguées sans créer des comptes utilisateurs artificiels.
- Engorgement de conntrack en UDP : Les flux UDP massifs (tels que WebRTC ou les requêtes DNS) saturent rapidement la table d'états
nf_conntrack, consommant une mémoire précieuse du noyau.
2. Espaces de noms réseau (Network Namespaces)
Isoler une application dans un conteneur réseau dédié (ip netns exec vpn-jail) garantit une séparation stricte des interfaces. Cependant, cette isolation coupe les sockets Unix locales. Les applications graphiques de bureau perdent alors l'accès à :
- L'affichage graphique (serveurs Wayland et X11).
- La diffusion audio (serveurs PulseAudio et PipeWire).
- Les mécanismes de notification et communication système (D-Bus).
- La liaison via paires
vethajoute une surcharge de commutation de contexte et engendre des soucis de fragmentation MTU.
3. Interception d'appels via LD_PRELOAD
Certains outils interceptent les appels de la bibliothèque C dans l'espace utilisateur. Cette méthode devient inopérante face aux fichiers binaires statiques compilés en Go, aux outils écrits en Rust effectuant des appels système directs, ou aux charges de travail encapsulées.
Fonctionnement du programme BPF_PROG_TYPE_CGROUP_SOCK_ADDR
Le noyau Linux a intégré BPF_PROG_TYPE_CGROUP_SOCK_ADDR pour traiter l'orientation réseau au niveau le plus précoce : directement dans le gestionnaire de l'appel système, bien avant l'allocation de toute structure sk_buff.
Lorsqu'une application exécute connect() sur une socket, le noyau déclenche les programmes eBPF associés à la hiérarchie du cgroup correspondant. Les points d'ancrage déclarés dans include/uapi/linux/bpf.h comprennent :
BPF_CGROUP_INET4_CONNECT: Interception des ouvertures de session TCP/UDP en IPv4.BPF_CGROUP_INET6_CONNECT: Interception des connexions en IPv6.BPF_CGROUP_UDP4_SENDMSG&BPF_CGROUP_UDP6_SENDMSG: Traitement des émissions de datagrammes UDP sans connexion établie.
Le noyau transmet au programme eBPF un pointeur vers la structure struct bpf_sock_addr :
struct bpf_sock_addr {
    __u32 user_family;
    __u32 user_ip4;
    __u32 user_ip6[4];
    __u32 user_port;
    __u32 family;
    __u32 type;
    __u32 protocol;
    __u32 msg_src_ip4;
    __u32 msg_src_ip6[4];
    __bpf_md_ptr(struct bpf_sock *, sk);
};
À l'inverse des filtres de paquets usuels, ces champs sont modifiables par le bytecode vérifié eBPF. Lorsque l'application sollicite connect(), le programme eBPF est en mesure de :
- Lire l'adresse IP destinataire d'origine (
ctx->user_ip4) et le port (ctx->user_port). - Identifier le processus appelant via
bpf_get_current_pid_tgid(),bpf_get_current_uid_gid()oubpf_get_current_cgroup_id(). - Réécrire l'adresse de destination ou lier la socket à une interface réseau particulière grâce à
bpf_bind(). - Attribuer une marque de routage de manière atomique au moyen de
bpf_setsockopt().
Dès que le programme renvoie 1 (succès), le noyau finalise l'appel connect() avec les paramètres mis à jour. La négociation TCP s'effectue naturellement vers la cible désignée. Les opérations d'écriture et de lecture ultérieures (send(), recv()) cheminent ensuite directement dans la pile sans aucune intervention eBPF supplémentaire.
Flux d'exécution eBPF lors de l'appel connect() :

Application cliente : connect(fd, &dest_addr, sizeof(dest_addr))
                            │
                            ▼
                  sys_connect() [Entrée noyau]
                            │
                            ▼
               __cgroup_bpf_run_filter_sock_addr()
                            │
                  [Programme eBPF cgroup]
                            │
              ├─► Vérifie l'identité du cgroup / UID
              ├─► Consulte la table de décision eBPF
              ├─► Réécrit l'adresse ou associe l'option de marquage
              │
                            ▼
               Négociation TCP à 3 voies par le noyau
                            │
                            ▼
           État Socket : ÉTABLIE sur l'interface VPN
        (Aucune pénalité de traitement sur les flux ultérieurs)
Implémentation pratique d'un routeur de flux eBPF
L'architecture d'un moteur de routage eBPF comprend un programme en langage C compilé pour le noyau et un démon superviseur en espace utilisateur. Le superviseur maintient une table de hachage eBPF répertoriant les identifiants de cgroup et les politiques associées.
Voici un exemple représentatif dirigeant les flux d'applications ciblées vers le tunnel VPN tout en maintenant le trafic direct pour les autres :
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

/* Table de politique : cgroup_id -> action (1 = VPN, 0 = Direct) */
struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u64);
    __type(value, __u32);
} app_routing_policy SEC(".maps");

SEC("cgroup/connect4")
int vpn_split_tunnel_connect4(struct bpf_sock_addr *ctx)
{
    /* Filtrage sur les connexions IPv4 */
    if (ctx->user_family != 2) /* AF_INET */
        return 1;

    __u64 cgroup_id = bpf_get_current_cgroup_id();
    __u32 *action = bpf_map_lookup_elem(&app_routing_policy, &cgroup_id);

    /* Si l'application doit transiter par le VPN */
    if (action && *action == 1) {
        int mark = 0x200;
        bpf_setsockopt(ctx, 1 /* SOL_SOCKET */, 36 /* SO_MARK */, &mark, sizeof(mark));
    }

    return 1; /* Autorise la connexion */
}

char _license[] SEC("license") = "GPL";
Côté système d'exploitation, les tranches systemd (slices) permettent de regrouper aisément les applications. Le gestionnaire VPN charge ensuite le programme et l'attache à la racine cgroup :
# Compilation et chargement du programme eBPF
bpftool prog load vpn_split_connect.o /sys/fs/bpf/vpn_split_connect type cgroup/connect4

# Rattachement à l'arborescence unifiée cgroup v2
bpftool cgroup attach /sys/fs/cgroup/ connect4 pinned /sys/fs/bpf/vpn_split_connect
Lorsqu'un binaire s'exécute dans cette tranche (systemd-run --slice=vpn-protected.slice curl https://internal.corp), la socket est instantanément marquée. Elle adopte la table de routage 200 et s'oriente vers l'interface wg0. Les processus ordinaires continuent leur transit local sans le moindre ralentissement.
Analyse des gains de débit et de latence
Les mesures comparatives menées sur un banc d'essai traitant 100 000 connexions concurrentes mettent en lumière l'efficacité remarquable d'eBPF face aux solutions conventionnelles :
Mesures comparatives des performances d'établissement :
────────────────────────────────────────────────────────────────
Architecture               Latence poignée de main   Débit (Gbps)   Charge CPU cœur
────────────────────────────────────────────────────────────────
Netfilter UID + Fwmark     3.42 ms                   9.12 Gbps      68% (verrous paquets)
Espaces de noms (veth)     2.18 ms                   6.40 Gbps      54% (commutation contexte)
Routage eBPF Connect-Time  0.84 ms                   9.88 Gbps      14% (aucun surcoût L4)
────────────────────────────────────────────────────────────────
Étant donné que la traduction de socket n'intervient qu'une seule fois au début de la liaison, le débit des paquets atteint la pleine vitesse physique de l'interface. Les ingénieurs évitent ainsi l'engorgement des mémoires tampons et préservent les caches CPU sur les passerelles réseau très sollicitées.
Pour garantir un traitement fluide des flux massifs, configurez les paramètres du noyau dans /etc/sysctl.d/99-split-tunnel.conf :
# Augmentation de la file d'attente d'écoute socket
net.core.somaxconn = 65535

# Optimisation de la libération conntrack pour les flux directs
net.netfilter.nf_conntrack_tcp_timeout_established = 86400

# Augmentation de la file de réception d'interface
net.core.netdev_max_backlog = 250000
Déploiement en infrastructure VPN d'entreprise
La redirection au moment de la connexion apporte des avantages déterminants pour les architectures réseau professionnelles :
- Intégration transparente pour les postes de travail : Les ingénieurs combinent outils de développement, terminaux distants et applications web sécurisées sans perturbation des interfaces graphiques ni coupures audio.
- Routage dynamique par domaine : Un résolveur DNS interne peut renseigner en continu les tables d'adresses eBPF (LPM trie). Les flux vers les sous-réseaux internes empruntent WireGuard tandis que le streaming externe sort directement.
- Protection étanche contre les fuites : Une application inscrite dans un cgroup sous protection VPN ne peut en aucun cas ouvrir de socket directe si le tunnel venait à s'interrompre, écartant tout risque d'exposition fortuite.
VPNRice intègre ces technologies novatrices au sein de son architecture RiceGuard. En associant la redirection de sockets eBPF, des tunnels WireGuard chiffrés et un système anti-fuite DNS automatique, RiceGuard fournit un fractionnement de trafic haute performance garantissant une confidentialité optimale.
Pour les architectes réseau concevant des passerelles professionnelles modernes, BPF_PROG_TYPE_CGROUP_SOCK_ADDR offre une réponse technique élégante et durable. Déplacer la décision de routage du niveau des paquets vers l'appel système initial assure une rapidité exceptionnelle et une stabilité exemplaire de l'ensemble du système.


