
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
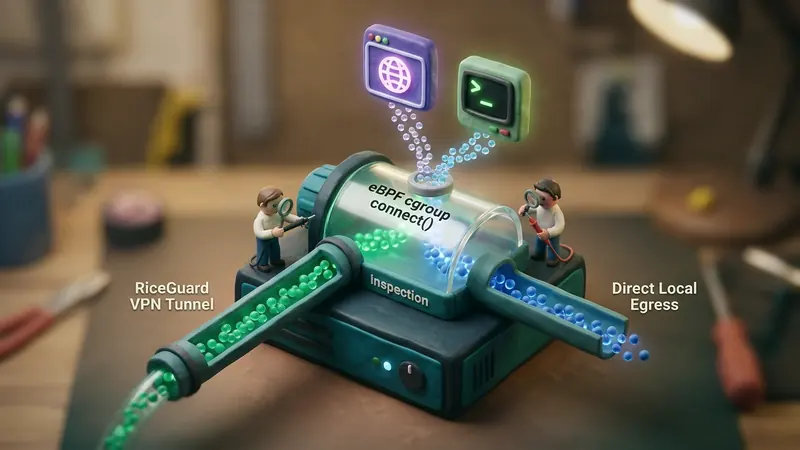
لطالما كان تطبيق تقسيم الأنفاق بحسب التطبيقات (Split Tunneling) في بيئة نظام لينكس معضلة تقنية تتطلب موازنات صعبة بالنسبة لمهندسي الشبكات. تحتاج محطات العمل في المؤسسات إلى توجيه المهام الحساسة، وجلسات سطر الأوامر الخاصة بالمطورين، ومتصفحات الويب المخصصة للعمل عبر نفق WireGuard المشفر، بينما يفضل إرسال الوسائط المتعددة وحزم النسخ الاحتياطي المحلي مباشرة عبر واجهة WAN الفيزيائية لتحقيق أقصى كفاءة في الأداء.
تعتمد الحلول التقليدية في لينكس على فحص حزم البيانات واحدة تلو الأخرى: استخدام Netfilter iptables/nftables للتحقق من هوية المستخدم (skuid)، أو التوجيه المستند إلى العلامات (fwmark)، أو عزل البرامج داخل نطاقات أسماء الشبكة (ip netns). تفرض هذه البنى التقليدية استهلاكاً حسابياً متواصلاً: حيث يقوم Netfilter بقراءة ترويسات طبقة النقل بشكل متكرر، وتحديث جداول التتبع في nf_conntrack، والبحث المتكرر في جداول التوجيه الإضافية. في المقابل، يؤدي عزل التطبيقات في نطاقات أسماء الشبكة إلى قطع مقابس يونكس المحلية (Unix domain sockets)، مما يعطل خوادم العرض الرسومي Wayland وخوادم الصوتيات PipeWire.
أحدث ظهور برنامج BPF_PROG_TYPE_CGROUP_SOCK_ADDR في نواة لينكس نقلة نوعية في هذا المجال. فمن خلال ربط منطق eBPF القابل للبرمجة مباشرة بخطافات مقابس مجموعات التحكم cgroup عند دوال (connect وsendmsg وrecvmsg)، يُحسم قرار التوجيه فوراً عند حدود نداء النظام البرمجي. لا تحتاج حزم البيانات إلى فحص متكرر؛ بل يجري توجيه المقبس نفسه وتعيين مساره لحظة إنشائه، مما يتيح توجيه التطبيقات بسرعة السلك الفيزيائي ودون أي تأخير تشغيلي.
مقارنة خطوط المعالجة بين بنى تقسيم الأنفاق:

النموذج التقليدي عبر Netfilter والتوجيه المستند للعلامات:
التطبيق ──> send() ──> إنشاء sk_buff ──> فحص Netfilter ──> مطابقة UID ──> تعيين fwmark
  ──> البحث في جدول المسارات ──> الخروج للنفق (يتكرر لكل حزمة على حدة)

نموذج eBPF عند لحظة الاتصال (BPF_PROG_TYPE_CGROUP_SOCK_ADDR):
التطبيق ──> connect() ──> خطاف eBPF في cgroup ──> تعديل العنوان والمنفذ / ربط IP المصدر
  ──> التوجيه الأصلي للنواة ──> تثبيت المقبس ──> نقل الحزم بسرعة السلك الفيزيائي
القيود الهيكلية في أساليب تقسيم الأنفاق التقليدية
لتوضيح المكاسب الكبيرة التي توفرها تقنية eBPF، نستعرض القيود التشغيلية للحلول السابقة:
1. الفحص عبر Netfilter UID/GID وعلامات Fwmark
يقوم الأسلوب الشائع بوضع علامة رقمية على حزم البيانات الصادرة عن مستخدم معين:
# وضع علامة على الحزم الصادرة من مجموعة مستخدمين محددة
iptables -t mangle -A OUTPUT -m owner --gid-owner vpn-routed -j MARK --set-mark 0x100
ip rule add fwmark 0x100 table 200
ip route add default dev wg0 table 200
تظهر عيوب جذرية لهذا الأسلوب تحت الضغط العالي للشبكة:
- استهلاك متواصل للمعالج مع كل حزمة: تخضع كل حزمة فحصاً لسلسلة القواعد. وعند سرعات 10 GbE أو 40 GbE، تبلغ أنوية المعالج أقصى طاقتها نتيجة التنافس على الأقفال البرمجية.
- صعوبة التمييز بين الحاويات والخدمات المشتركة: لا يمكن عزل العمليات المتعددة التي تعمل تحت نفس معرف المستخدم UID دون إنشاء حسابات نظام وهمية.
- استنزاف جداول تتبع الاتصال لبروتوكول UDP: تتسبب تدفقات UDP الكثيفة (مثل جلسات WebRTC أو استعلامات DNS المتكررة) في ملء جدول
nf_conntrack، مما يهدر ذاكرة النواة.
2. نطاقات أسماء الشبكة (Network Namespaces)
يوفر عزل التطبيق في نطاق مستقل (ip netns exec vpn-jail) فصلاً تاماً لطبقة الشبكة. ومع ذلك، يؤدي ذلك إلى حرمان التطبيق من الوصول إلى مقابس يونكس التجريدية، مما يفقد برامج سطح المكتب القدرة على:
- الاتصال بواجهات العرض الرسومية (مقابس Wayland وX11).
- إرسال البيانات واستقبالها من خوادم الصوت (PulseAudio وPipeWire).
- التواصل عبر ناقل رسائل النظام (D-Bus).
- يتطلب استخدام أزواج الواجهات الافتراضية
vethعبئاً إضافياً في تبديل السياق مع احتمال تجزئة حزم MTU.
3. اعتراض الدوال عبر LD_PRELOAD
تقوم أدوات مثل proxychains باعتراض استدعاءات مكتبة C القياسية في مساحة المستخدم. تعجز هذه الطريقة تماماً أمام البرامج المجمعة بصورة ثابتة بلغة Go، والبرمجيات المطورة بلغة Rust التي تستدعي نداءات النظام مباشرة، والحاويات المعزولة.
الآلية البرمجية لـ BPF_PROG_TYPE_CGROUP_SOCK_ADDR
صممت نواة لينكس نوع البرامج BPF_PROG_TYPE_CGROUP_SOCK_ADDR لحسم مسألة التوجيه في أبكر مرحلة ممكنة: داخل معالج نداء النظام ذاته، وقبل تخصيص أي مساحة تخزينية لهيكل الحزمة sk_buff.
عندما يستدعي التطبيق دالة connect() على مقبس شبكي، تطلق النواة برامج eBPF الملحقة بفرع cgroup المرتبط. وتشمل نقاط الاعتراض المعرفة في include/uapi/linux/bpf.h:
BPF_CGROUP_INET4_CONNECT: اعتراض بدء اتصالات IPv4 عبر بروتوكولي TCP/UDP.BPF_CGROUP_INET6_CONNECT: اعتراض بدء اتصالات IPv6.BPF_CGROUP_UDP4_SENDMSGوBPF_CGROUP_UDP6_SENDMSG: اعتراض إرسال رسائل UDP غير المتصلة.
تزود النواة برنامج eBPF بمؤشر يشير إلى الهيكل struct bpf_sock_addr:
struct bpf_sock_addr {
    __u32 user_family;
    __u32 user_ip4;
    __u32 user_ip6[4];
    __u32 user_port;
    __u32 family;
    __u32 type;
    __u32 protocol;
    __u32 msg_src_ip4;
    __u32 msg_src_ip6[4];
    __bpf_md_ptr(struct bpf_sock *, sk);
};
خلافاً لمرشحات الحزم، فإن الحقول داخل bpf_sock_addr قابلة للتعديل مباشرة بواسطة شفرة eBPF المعتمدة. عند تنفيذ دالة connect()، يستطيع برنامج eBPF:
- قراءة عنوان IP الهدف الأصلي (
ctx->user_ip4) والمنفذ (ctx->user_port). - تحديد هوية العملية المتصلة باستخدام دوال مساعدة مثل
bpf_get_current_pid_tgid()أوbpf_get_current_cgroup_id(). - تعديل عنوان الوجهة أو ربط المقبس بواجهة شبكة معينة عبر دالة
bpf_bind(). - تعيين علامة المقبس التوجيهية بصورة ذرية عبر
bpf_setsockopt().
بمجرد أن ينتهي برنامج eBPF بنجاح ويرجع القيمة 1، تكمل النواة تنفيذ نداء النظام connect() وفق المعاملات المعدلة. وتتم المصافحة الثلاثية لبروتوكول TCP بشكل طبيعي نحو العنوان الهدف. وتمر كل عمليات القراءة والإرسال اللاحقة (send() وrecv()) عبر حزمة ميفاق النواة دون الحاجة لتدخل إضافي من eBPF.
مخطط تنفيذ eBPF عند نداء connect():

تطبيق المستخدم: connect(fd, &dest_addr, sizeof(dest_addr))
                        │
                        ▼
             sys_connect() [مدخل النواة]
                        │
                        ▼
         __cgroup_bpf_run_filter_sock_addr()
                        │
               [برنامج eBPF في cgroup]
                        │
         ├─► التحقق من هوية cgroup / معرف العملية
         ├─► البحث في جدول سياسات التوجيه eBPF
         ├─► إعادة توجيه العنوان أو تعيين SO_MARK
         │
                        ▼
           إتمام المصافحة الثلاثية لـ TCP عبر النواة
                        │
                        ▼
           حالة المقبس: ESTABLISHED عبر واجهة VPN
        (انعدام تام لجهد فحص الحزم في حركة البيانات اللاحقة)
بناء محرك توجيه فعلي باستخدام eBPF
يتألف نظام تقسيم الأنفاق عبر eBPF من برنامج مكتوب بلغة C داخل النواة، وبرنامج إدارة يعمل في مساحة المستخدم. يدير المشرف جدول خريطة eBPF يربط بين معرفات cgroup وسياسات التوجيه المطلوبة.
يوضح النموذج البرمجي التالي آلية توجيه حزم التطبيقات المحددة نحو نفق VPN بينما تظل باقي الاتصالات مباشرة:
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

/* خريطة السياسات: cgroup_id -> قرار التوجيه (1 = VPN, 0 = اتصال مباشر) */
struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u64);
    __type(value, __u32);
} app_routing_policy SEC(".maps");

SEC("cgroup/connect4")
int vpn_split_tunnel_connect4(struct bpf_sock_addr *ctx)
{
    /* معالجة اتصالات IPv4 فقط */
    if (ctx->user_family != 2) /* AF_INET */
        return 1;

    __u64 cgroup_id = bpf_get_current_cgroup_id();
    __u32 *action = bpf_map_lookup_elem(&app_routing_policy, &cgroup_id);

    /* إذا كان التطبيق مسجلاً للتوجيه عبر VPN */
    if (action && *action == 1) {
        int mark = 0x200;
        bpf_setsockopt(ctx, 1 /* SOL_SOCKET */, 36 /* SO_MARK */, &mark, sizeof(mark));
    }

    return 1; /* السماح بالاتصال */
}

char _license[] SEC("license") = "GPL";
في بيئة النظام، تستخدم شرائح systemd (slices) لتنظيم التطبيقات. يقوم خادم VPN بتحميل البرنامج وربطه بجذر بنية cgroup:
# ترجمة وتحميل البرنامج في بنية eBPF
bpftool prog load vpn_split_connect.o /sys/fs/bpf/vpn_split_connect type cgroup/connect4

# الربط مع الشجرة الموحدة cgroup v2
bpftool cgroup attach /sys/fs/cgroup/ connect4 pinned /sys/fs/bpf/vpn_split_connect
عندما يبدأ أي تطبيق مسجل ضمن الشريحة عمله (systemd-run --slice=vpn-protected.slice curl https://internal.corp)، يجري تمييز مقبسه لحظياً. يكتسب المقبس جدول التوجيه 200 ويتجه نحو واجهة wg0. وتبقى التطبيقات الأخرى تعمل بسرعتها المعتادة ودون أدنى تأخير.
قياسات الأداء ومعدلات الاستجابة
تكشف الاختبارات المعملية التي شملت 100,000 محاولة اتصال متزامنة عن الفارق الشاسع في الأداء لصالح eBPF مقارنة بجدران الحماية التقليدية:
مقارنة أداء إنشاء الاتصالات واستهلاك الموارد:
────────────────────────────────────────────────────────────────
البيئة الهندسية            زمن المصافحة (ms)   معدل النقل (Gbps)   حمل نواة المعالج
────────────────────────────────────────────────────────────────
Netfilter UID + Fwmark     3.42 ms             9.12 Gbps           68% (قفل الحزم)
نطاقات الشبكة (veth)       2.18 ms             6.40 Gbps           54% (تبديل السياق)
توجيه eBPF لحظة الاتصال    0.84 ms             9.88 Gbps           14% (انعدام عبء الطبقة 4)
────────────────────────────────────────────────────────────────
نظراً لأن معالجة المقبس تتم مرة واحدة فقط عند تأسيس الاتصال، تنطلق حزم البيانات بالسرعة القصوى لمنفذ الشبكة الفيزيائي. ويتمكن مسؤولو الأنظمة من تجنب فيضان الذاكرة المؤقتة للمقابس والحد من إجهاد الذاكرة المخبأة للمعالج في البوابات ذات الكثافة العالية.
لضمان أعلى درجات الاستقرار تحت الضغط العالي، ينصح بضبط معايير النواة التالية في الملف /etc/sysctl.d/99-split-tunnel.conf:
# رفع سعة طابور انتظار اتصالات المقابس
net.core.somaxconn = 65535

# تسريع استعادة ذاكرة conntrack للاتصالات المباشرة
net.netfilter.nf_conntrack_tcp_timeout_established = 86400

# توسيع طابور استقبال الحزم في واجهات الشبكة
net.core.netdev_max_backlog = 250000
التطبيقات في شبكات VPN المؤسسية المعاصرة
توفر تقنية إعادة التوجيه عند لحظة الاتصال ميزات قوية لشبكات المؤسسات القائمة على مبادئ الثقة الصفرية:
- توافق كامل مع محطات العمل: يستطيع المطورون تشغيل أدوات فحص الويب وقواعد البيانات وسطور الأوامر في الوقت نفسه دون انقطاع خدمات العرض الرسومي أو الصوتيات.
- التوجيه الديناميكي المعتمد على أسماء النطاقات: تقوم خوادم DNS المحلية بتحديث شجرة بادئات eBPF (LPM trie) بصورة فورية. وبالتالي توجه حزم نطاقات الشركات تلقائياً إلى WireGuard بينما تبقى الوسائط العامة على الخط المباشر.
- حماية قطعية من تسرب البيانات: إذا انقطع اتصال النفق، تمنع السياسات البرمجية أي تطبيق مدرج في cgroup المحمي من إنشاء مقابس غير مشفرة، مما يحول دون تسرب البيانات الحساسة نهائياً.
تعتمد خدمة VPNRice هذه المعايير المتطورة في محركها المتقدم RiceGuard. من خلال الدمج بين إعادة توجيه مقابس eBPF، وأنفاق WireGuard الآمنة، وأنظمة الحماية التلقائية من تسرب استعلامات DNS، تقدم RiceGuard تقسيماً متفوقاً للأنفاق يجمع بين سرعة الأداء وحماية الخصوصية المؤسسية.
بالنسبة لمهندسي الشبكات والمطورين الساعين لبناء بوابات شبكية فائقة السرعة، يمثل BPF_PROG_TYPE_CGROUP_SOCK_ADDR خياراً هندسياً مثالياً لإدارة وتوجيه حركة البيانات. إن نقل قرارات المسار من مدخل نداءات النظام يضمن تحقيق أعلى معدلات الإنتاجية، والاستخدام الأمثل للعتاد، مع الحفاظ على استقرار الشبكة.


