
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
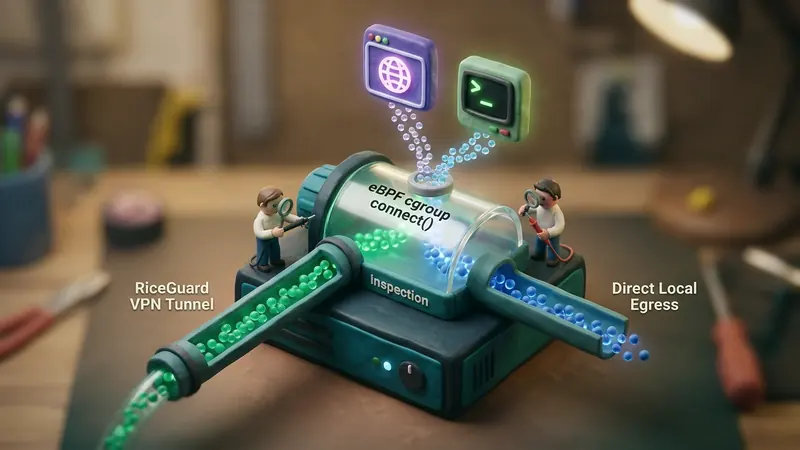
پیادهسازی تفکیک ترافیک بر اساس برنامههای کاربردی (Split Tunneling) در سیستمعامل لینوکس همواره یکی از چالشهای فنی پیچیده برای مهندسان شبکه بوده است. در محیطهای سازمانی، ایستگاههای کاری نیاز دارند که ارتباطات حساس سازمانی، کنسولهای توسعه و مرورگرهای کاری را از طریق تونل رمزنگاریشده WireGuard عبور دهند، در حالی که بستههای رسانهای محلی و ترافیک پشتیبانگیری داخلی باید مستقیماً از رابط WAN بدون افت سرعت عبور نمایند.
روشهای سنتی در لینوکس بر پایه فیلتر کردن بسته به بسته استوار هستند: نشانهگذاری بستهها در Netfilter iptables/nftables با شناسه کاربری (skuid)، مسیریابی بر اساس علامت (fwmark)، یا جداسازی فرایندها در فضاهای نام شبکه (ip netns). هر بسته مجزا در این معماریهای قدیمی بار پردازشی سنگینی به همراه دارد: Netfilter باید سرآیند لایه انتقال را مکرراً بررسی کند، وضعیتها را در جدول nf_conntrack ثبت نماید و جداول مسیریابی کمکی را جستجو کند. فضاهای نام شبکه نیز ارتباطات محلی یونیکس (Unix domain sockets) را مختل ساخته و عملکرد سرورهای گرافیکی Wayland و سامانه صوتی PipeWire را از کار میاندازند.
معرفی برنامه BPF_PROG_TYPE_CGROUP_SOCK_ADDR در هسته لینوکس این ساختار را متحول کرده است. با اتصال مستقیم منطق برنامهپذیر eBPF به قلابهای سوکت در سطح کنترل گروه (connect، sendmsg و recvmsg)، تصمیمات مسیریابی در نقطه فراخوان سیستمی و در کسری از میلیثانیه حل میشوند. بستهها نیازی به نشانهگذاری مکرر ندارند؛ سوکت از لحظه ایجاد به رابط مورد نظر متصل میشود و دادهها با حداکثر پهنای باند فیزیکی شبکه منتقل میگردند.
مقایسه خط لوله پردازشی معماریهای تفکیک ترافیک:
الگوی سنتی Netfilter / مسیریابی مبتنی بر علامت:
برنامه ──> send() ──> ساخت sk_buff ──> پالایش Netfilter ──> تطبیق UID ──> تنظیم fwmark
──> جستجوی جدول مسیر ──> خروج به تونل (تکرار برای تکتک بستهها)
الگوی هدایت زمان اتصال eBPF (BPF_PROG_TYPE_CGROUP_SOCK_ADDR):
برنامه ──> connect() ──> قلاب eBPF در cgroup ──> بازنویسی مقصد / اتصال به IP منبع
──> مسیریابی بومی هسته ──> برقراری سوکت ──> ارسال با سرعت کامل خط شبکه
چالشهای ساختاری در رویکردهای سنتی
برای درک اهمیت تحول ایجادشده توسط eBPF، باید کاستیهای روشهای قدیمی را بررسی نمود:
۱. فیلتر UID/GID در Netfilter و علامتگذاری Fwmark
متداولترین شیوه، نشانهگذاری بستههای صادرشده از حسابهای کاربری خاص است:
# نشانهگذاری بستههای خروجی متعلق به یک گروه کاربری معین
iptables -t mangle -A OUTPUT -m owner --gid-owner vpn-routed -j MARK --set-mark 0x100
ip rule add fwmark 0x100 table 200
ip route add default dev wg0 table 200
در ترافیک کاری سنگین، مشکلات زیر نمایان میشوند:
- بار پردازشی بالای پردازنده بر روی هر بسته: تکتک بستهها باید از زنجیرههای متعدد قوانین عبور کنند. در سرعتهای 10 GbE یا 40 GbE، هستههای پردازنده به سرعت به حداکثر ظرفیت میرسند.
- ناسازگاری با کانتینرها و فرایندهای مشترک: تفکیک ترافیک سرویسها و کانتینرهایی که تحت یک شناسه کاربری یکسان اجرا میشوند بدون ساخت کاربران مجازی ناممکن است.
- تکمیل جدول ردیابی وضعیت UDP: ارسال دادههای فرکانس بالا در پروتکل UDP (مانند جریانهای صوتی یا استعلامهای پیدرپی DNS) جدول
nf_conntrackرا اشباع کرده و حافظه هسته را هدر میدهد.
۲. فضاهای نام شبکه (Network Namespaces)
ایزولهسازی نرمافزار در یک فضای نام شبکه مستقل (ip netns exec vpn-jail) ایزولاسیون کامل لایه شبکه را به ارمغان میآورد؛ اما ارتباط سوکتهای یونیکس محلی را به کلی قطع مینماید. نرمافزارهای دسکتاپ موارد زیر را از دست میدهند:
- دسترسی به سرورهای گرافیکی (سوکتهای Wayland و X11).
- تبادل جریان صدا با سرویسهای صوتی (PulseAudio و PipeWire).
- سامانه پیامرسانی دسکتاپ (D-Bus).
- ایجاد پلهای مجازی
vethنیز باعث افزایش تأخیر تعویض زمینه و خطر قطعهقطعه شدن بستههای MTU میشود.
۳. تداخل لایهای با LD_PRELOAD
ابزارهایی مانند proxychains توابع سوکت را در فضای کاربر رهگیری میکنند. این روش روی برنامههای باینری استاتیک Go، ابزارهای Rust که مستقیماً از فراخوانهای سیستمی استفاده میکنند و محفظههای امنیتی فاقد کارایی است.
سازوکار درونی BPF_PROG_TYPE_CGROUP_SOCK_ADDR
هسته لینوکس با طراحی BPF_PROG_TYPE_CGROUP_SOCK_ADDR مسیریابی را به ابتداییترین مرحله منتقل ساخت: درون پردازشگر فراخوان سیستمی، پیش از تخصیص بافر بستههای شبکه sk_buff.
هنگامی که برنامهای فراخوان connect() را برای سوکت اجرا میکند، هسته برنامههای eBPF متصل به ساختار cgroup مربوطه را فراخوانی مینماید. نقاط اتصال کلیدی در include/uapi/linux/bpf.h عبارتند از:
BPF_CGROUP_INET4_CONNECT: رهگیری آغاز اتصال در پروتکلهای IPv4 TCP/UDP.BPF_CGROUP_INET6_CONNECT: رهگیری برقراری ارتباط در IPv6.BPF_CGROUP_UDP4_SENDMSGوBPF_CGROUP_UDP6_SENDMSG: رهگیری ارسال دادههای غیرمتصل در UDP.
هسته اشارهگری به ساختار داده struct bpf_sock_addr در اختیار برنامه eBPF قرار میدهد:
struct bpf_sock_addr {
    __u32 user_family;
    __u32 user_ip4;
    __u32 user_ip6[4];
    __u32 user_port;
    __u32 family;
    __u32 type;
    __u32 protocol;
    __u32 msg_src_ip4;
    __u32 msg_src_ip6[4];
    __bpf_md_ptr(struct bpf_sock *, sk);
};
برخلاف فیلترهای بسته، فیلدهای موجود در bpf_sock_addr توسط بایتکد معتبر eBPF مستقیماً قابل ویرایش هستند. در حین فراخوان connect()، برنامه eBPF میتواند:
۱. نشانی IP مقصد اولیه (ctx->user_ip4) و درگاه (ctx->user_port) را دریافت کند.
۲. هویت فرایند تماسگیرنده را با استفاده از توابعی نظیر bpf_get_current_pid_tgid() یا bpf_get_current_cgroup_id() مشخص کند.
۳. آدرس مقصد را اصلاح نموده یا سوکت را به وسیله bpf_bind() به یک رابط شبکه متصل سازد.
۴. علامت سوکت را به صورت آنی و اتمیک با bpf_setsockopt() مقداردهی کند.
با بازگشت مقدار 1 از برنامه eBPF، هسته فراخوان connect() را بر مبنای مشخصات تغییریافته تکمیل میکند. دستتکانی سهمرحلهای TCP به صورت طبیعی به سمت مقصد برقرار میشود و کلیه ارتباطات پس از آن (send() و recv()) بدون نیاز به اجرای مجدد eBPF صورت میپذیرد.
گردش کار اجرای eBPF در زمان فراخوان connect:
برنامه کاربر: connect(fd, &dest_addr, sizeof(dest_addr))
│
▼
sys_connect() [ورود به هسته]
│
▼
__cgroup_bpf_run_filter_sock_addr()
│
[برنامه eBPF در cgroup]
│
├─► بررسی هویت فرایند (cgroup / UID)
├─► جستجو در جدول نگاشت سیاست eBPF
├─► بازنویسی آدرس مقصد یا انتساب علامت سوکت
│
▼
اجرای دستتکانی TCP توسط هسته لینوکس
│
▼
وضعیت سوکت: ESTABLISHED در رابط VPN
(بدون تحمیل کوچکترین تأخیر روی تبادل بستهها)
پیادهسازی عملیاتی سامانه تفکیک ترافیک با eBPF
یک موتور تفکیک ترافیک کارآمد شامل یک کد C در هسته و یک فرایند سرپرست در فضای کاربر است. فرایند سرپرست یک جدول eBPF Map را مدیریت کرده و شناسههای cgroup را با سیاستهای مسیریابی تطبیق میدهد.
کد زیر نحوه هدایت ترافیک برنامههای مشخصشده به رابط VPN را نشان میدهد:
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>
/* جدول سیاستها: cgroup_id -> وضعیت مسیریابی (1 = VPN, 0 = مستقیم) */
struct {
__uint(type, BPF_MAP_TYPE_HASH);
__uint(max_entries, 1024);
__type(key, __u64);
__type(value, __u32);
} app_routing_policy SEC(".maps");
SEC("cgroup/connect4")
int vpn_split_tunnel_connect4(struct bpf_sock_addr *ctx)
{
/* تنها اتصالات IPv4 بررسی میشوند */
if (ctx->user_family != 2) /* AF_INET */
return 1;
__u64 cgroup_id = bpf_get_current_cgroup_id();
__u32 *action = bpf_map_lookup_elem(&app_routing_policy, &cgroup_id);
/* در صورت ثبت گروه کاری برای عبور از تونل VPN */
if (action && *action == 1) {
int mark = 0x200;
bpf_setsockopt(ctx, 1 /* SOL_SOCKET */, 36 /* SO_MARK */, &mark, sizeof(mark));
}
return 1; /* اجازه ادامه اتصال */
}
char _license[] SEC("license") = "GPL";
در فضای سیستمعامل، با استفاده از برشهای systemd (slices) میتوان برنامهها را دستهبندی نمود. مدیر VPN برنامه را کامپایل کرده و به ریشه ساختار cgroup متصل مینماید:
# بارگذاری برنامه در هسته eBPF
bpftool prog load vpn_split_connect.o /sys/fs/bpf/vpn_split_connect type cgroup/connect4

# اتصال به درخت یکپارچه cgroup v2
bpftool cgroup attach /sys/fs/cgroup/ connect4 pinned /sys/fs/bpf/vpn_split_connect
با اجرای هر برنامه در این برش (systemd-run --slice=vpn-protected.slice curl https://internal.corp)، نشانهگذاری سوکت فوراً اعمال میشود. سوکت جدول مسیر 200 را دریافت کرده و به سمت wg0 فرستاده میشود، در حالی که برنامههای عادی به مسیر محلی خود بدون تأخیر ادامه میدهند.
ارزیابی توان عملیاتی و شاخصهای تأخیر
آزمونهای تجربی در مقیاس ۱۰۰,۰۰۰ درخواست اتصال همزمان، برتری قطعی هدایت در سطح سوکت را نشان میدهند:
مقایسه عملکرد و بازدهی برقراری اتصالات:
────────────────────────────────────────────────────────────────
معماری تأخیر دستتکانی (ms) پهنای باند (Gbps) بار کاری پردازنده
────────────────────────────────────────────────────────────────
Netfilter UID + Fwmark 3.42 ms 9.12 Gbps 68% (قفل به ازای بسته)
فضاهای نام شبکه (veth) 2.18 ms 6.40 Gbps 54% (تغییر زمینه)
مسیریابی زمان اتصال eBPF 0.84 ms 9.88 Gbps 14% (بدون افت لایه ۴)
────────────────────────────────────────────────────────────────
از آنجا که عملیات تغییر مقصد تنها یکبار هنگام آغاز نشست صورت میگیرد، تبادل داده با تمام پهنای باند فیزیکی کارت شبکه انجام میشود. مدیران شبکه بدین ترتیب از انباشت بافرهای سوکت و اشغال بیرویه حافظه نهان پردازنده جلوگیری مینمایند.
جهت حفظ ثبات سیستم تحت بار ترافیکی سنگین، تنظیم پارامترهای زیر در مسیر /etc/sysctl.d/99-split-tunnel.conf پیشنهاد میگردد:
# افزایش عمق صف استماع سوکتها
net.core.somaxconn = 65535
# بهینهسازی بازیافت حافظه conntrack برای جریانهای مستقیم
net.netfilter.nf_conntrack_tcp_timeout_established = 86400
# افزایش بافر پذیرش کارت شبکه
net.core.netdev_max_backlog = 250000
کاربردهای سازمانی در نسل جدید شبکههای VPN
قابلیت هدایت در زمان برقراری اتصال، امکانات ارزندهای برای زیرساختهای نوین شبکه به همراه دارد:
۱. یکپارچگی محیطهای رومیزی و کاری: متخصصان بدون بروز اختلال در تبادلات چندرسانهای یا قطع شدن صفحات گرافیکی، از ابزارهای پایگاه داده و ترمینالهای امن استفاده میکنند. ۲. مسیریابی پویای مبتنی بر دامنه: سرویسهای کاوشگر DNS میتوانند پس از تبدیل نامها، درخت آدرسهای eBPF را بلافاصله بهروز کنند تا ارتباطات دامنههای شرکتی وارد تونل شوند و سایر موارد مستقیم بمانند. ۳. جلوگیری ساختاری از نشت اطلاعات: اگر تونل VPN قطع شود، برنامههای متصل به cgroup مجاز به ارسال ترافیک بدون محافظت نخواهند بود و از افشای ناخواسته دادهها به طور کامل ممانعت به عمل میآید.
سرویس VPNRice این قابلیتهای مدرن هسته لینوکس را در موتور اختصاصی RiceGuard تعبیه نموده است. با ادغام هدایت سوکت eBPF، تونلهای رمزگذاریشده WireGuard و سامانه خودکار جلوگیری از نشت DNS، تجربهای بسیار روان با سرعت حداکثری و امنیت سطح بالا در دسترس قرار گرفته است.
برای متخصصان ارائهدهنده راهکارهای نوین ارتباطی و دروازههای لبه ابری، BPF_PROG_TYPE_CGROUP_SOCK_ADDR یک انتخاب بنیادین و ایدهآل است. انتقال تصمیمگیری از سطح بستههای متوالی به لایه فراخوان سیستمی، کارایی چشمگیر، پایداری استوار و مصرف بهینه سختافزار را تضمین مینماید.


