
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
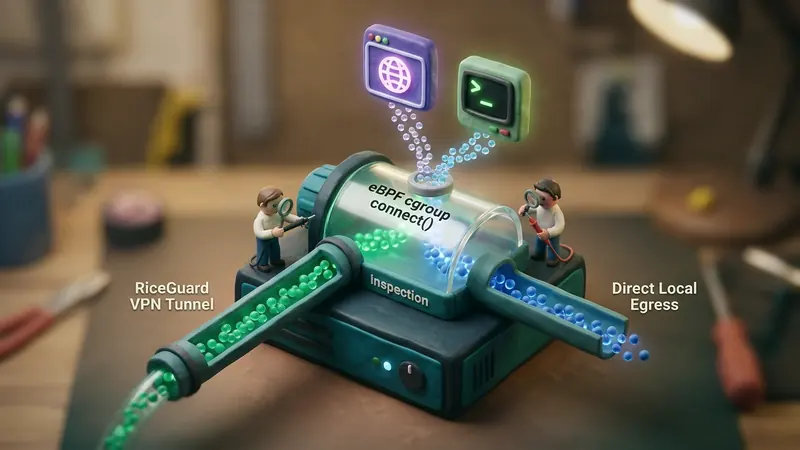
Phân tách luồng dữ liệu theo ứng dụng (split tunneling) trên hệ điều hành Linux từ lâu đã là bài toán hóc búa đối với các kỹ sư mạng. Người dùng doanh nghiệp cần định tuyến các tác vụ nội bộ nhạy cảm, terminal phát triển hoặc trình duyệt bảo mật qua đường hầm mã hóa WireGuard, trong khi các tác vụ truyền phát video băng thông lớn hay sao lưu NAS cục bộ cần đi thẳng ra mạng WAN nhằm tối ưu hiệu năng.
Các giải pháp truyền thống trên Linux đều dựa vào tầng kiểm tra gói tin: lọc theo danh tính người dùng (skuid) trong Netfilter iptables/nftables, đánh dấu gói qua fwmark, hoặc cô lập ứng dụng trong network namespace (ip netns). Mọi gói tin đi qua các kiến trúc cũ này đều phải chịu chi phí tính toán liên tục: Netfilter phải giải mã tiêu đề tầng giao vận lặp đi lặp lại, theo dõi trạng thái trong nf_conntrack, và tra cứu bảng định tuyến phụ. Trong khi đó, việc dùng network namespace lại chia cắt hoàn toàn giao tiếp IPC cục bộ, làm tê liệt giao diện đồ họa Wayland và hệ thống âm thanh PipeWire.
Sự xuất hiện của chương trình BPF_PROG_TYPE_CGROUP_SOCK_ADDR trong nhân Linux đã thay đổi hoàn toàn cục diện. Bằng cách gắn trực tiếp logic eBPF vào các điểm móc socket của cgroup (connect, sendmsg, và recvmsg), quyết định định tuyến được giải quyết triệt để ngay tại ranh giới lời gọi hệ thống (system call). Gói tin sau đó không cần phải gắn thẻ lặp lại hay soi xét trạng thái; chính socket đã được điều hướng ngay từ thời điểm khởi tạo, đem lại khả năng phân tách luồng với tốc độ tương đương đường truyền vật lý.
So sánh luồng xử lý giữa các kiến trúc Split Tunneling:

Mô hình Netfilter / Policy Routing truyền thống:
Ứng dụng ──> send() ──> Tạo sk_buff ──> Netfilter PREROUTING ──> Khớp UID ──> Gắn fwmark
  ──> Tra cứu Policy Routing ──> Đẩy vào Tunnel (Lặp lại trên từng gói đơn lẻ)

Mô hình eBPF Connect-Time (BPF_PROG_TYPE_CGROUP_SOCK_ADDR):
Ứng dụng ──> connect() ──> Hook eBPF (cgroup) ──> Ghi lại địa chỉ đích / Gán IP nguồn
  ──> Định tuyến gốc của Kernel ──> Thiết lập Socket ──> Truyền dữ liệu tốc độ phần cứng
Những hạn chế cốt lõi của giải pháp truyền thống
Để thấy rõ bước tiến vượt bậc của eBPF, chúng ta cần phân tích các cơ chế phân tách luồng thường gặp trước đây:
1. Lọc UID/GID qua Netfilter và Fwmark
Phương pháp phổ biến nhất là đánh dấu các gói tin phát sinh từ một nhóm tài khoản cụ thể:
# Gắn nhãn gói tin xuất phát từ nhóm người dùng chỉ định
iptables -t mangle -A OUTPUT -m owner --gid-owner vpn-routed -j MARK --set-mark 0x100
ip rule add fwmark 0x100 table 200
ip route add default dev wg0 table 200
Mô hình này tồn tại nhiều nhược điểm nghiêm trọng trong môi trường tải cao:
- Tốn chu kỳ CPU trên từng gói tin: Mọi gói tin gửi đi đều buộc Netfilter phải duyệt qua danh sách quy tắc và tra cứu bảng. Trên cổng mạng 10 GbE hay 40 GbE, CPU dễ dàng chạm ngưỡng bão hòa.
- Không tương thích với ứng dụng container và đa tiến trình: Các tiến trình chạy ngầm hoặc container dùng chung UID hệ thống rất khó phân tách mà không phải tạo tài khoản riêng rẽ.
- Làm nghẽn bảng theo dõi conntrack: Các lưu lượng UDP tần suất cao (như WebRTC hoặc truy vấn phân giải tên miền) nhanh chóng làm đầy bảng
nf_conntrack, gây tiêu tốn bộ nhớ nhân nghiêm trọng.
2. Không gian tên mạng (Network Namespaces)
Cô lập ứng dụng trong network namespace riêng (ip netns exec vpn-box) mang lại khả năng phân tách mạng tuyệt đối. Tuy nhiên, namespace lại cô lập toàn bộ ngăn xếp mạng, cắt đứt các socket miền Unix (Unix domain sockets). Ứng dụng máy tính để bàn sẽ mất khả năng:
- Kết nối tới máy chủ hiển thị đồ họa (socket Wayland và X11).
- Giao tiếp với hệ thống âm thanh (PulseAudio, PipeWire).
- Nhận thông báo qua thanh bus hệ thống (D-Bus).
- Việc bắc cầu mạng đòi hỏi cặp giao diện ảo
veth, làm gia tăng độ trễ chuyển ngữ cảnh và tiềm ẩn nguy cơ phân mảnh MTU.
3. Can thiệp thư viện bằng LD_PRELOAD
Các tiện ích như proxychains chặn lời gọi thư viện socket ở không gian người dùng. Cơ chế này mất tác dụng hoàn toàn đối với các ứng dụng biên dịch tĩnh bằng Go, các ứng dụng Rust gọi trực tiếp syscall, hoặc các phần mềm chạy trong môi trường container kín.
Cơ chế hoạt động của BPF_PROG_TYPE_CGROUP_SOCK_ADDR
Nhân Linux thiết kế BPF_PROG_TYPE_CGROUP_SOCK_ADDR nhằm giải quyết việc định tuyến tại điểm khởi đầu sớm nhất: ngay trong trình xử lý lời gọi hệ thống, trước khi bất kỳ cấu trúc đệm gói tin sk_buff nào được cấp phát.
Khi một ứng dụng gọi connect() trên một socket, nhân sẽ kích hoạt chương trình eBPF được liên kết với cây cgroup tương ứng. Các điểm móc chính trong include/uapi/linux/bpf.h gồm có:
BPF_CGROUP_INET4_CONNECT: Can thiệp quá trình khởi tạo kết nối IPv4 TCP/UDP.BPF_CGROUP_INET6_CONNECT: Can thiệp quá trình khởi tạo kết nối IPv6.BPF_CGROUP_UDP4_SENDMSG&BPF_CGROUP_UDP6_SENDMSG: Can thiệp luồng dữ liệu UDP không duy trì kết nối.
Nhân chuyển cho chương trình eBPF một con trỏ trỏ tới cấu trúc struct bpf_sock_addr:
struct bpf_sock_addr {
    __u32 user_family;
    __u32 user_ip4;
    __u32 user_ip6[4];
    __u32 user_port;
    __u32 family;
    __u32 type;
    __u32 protocol;
    __u32 msg_src_ip4;
    __u32 msg_src_ip6[4];
    __bpf_md_ptr(struct bpf_sock *, sk);
};
Khác biệt hoàn toàn với các hook lọc gói tin thông thường, các trường trong bpf_sock_addr có thể được ghi đè trực tiếp bởi mã byte eBPF hợp lệ. Khi ứng dụng gọi connect(), chương trình eBPF có thể:
- Đọc địa chỉ IP đích ban đầu (
ctx->user_ip4) và cổng (ctx->user_port). - Xác định tiến trình gọi qua các hàm trợ giúp như
bpf_get_current_pid_tgid(),bpf_get_current_uid_gid(), hoặcbpf_get_current_cgroup_id(). - Sửa đổi địa chỉ đích hoặc gắn kết socket vào một giao diện mạng cục bộ cụ thể bằng
bpf_bind(). - Đặt nhãn metadata của socket thông qua
bpf_setsockopt().
Khi chương trình eBPF trả về mã 1 (thành công), nhân tiếp tục hoàn tất lời gọi hệ thống connect() với các tham số đã qua xử lý. Quá trình bắt tay 3 bước của TCP diễn ra tự nhiên tới địa chỉ đích tương ứng. Mọi thao tác gửi nhận write(), send(), read() sau đó diễn ra bình thường trong ngăn xếp mạng của nhân mà không cần thêm sự can thiệp nào từ eBPF.
Quy trình thực thi eBPF tại thời điểm gọi connect:

Ứng dụng người dùng: connect(fd, &dest_addr, sizeof(dest_addr))
                           │
                           ▼
                 sys_connect() [Điểm vào nhân]
                           │
                           ▼
              __cgroup_bpf_run_filter_sock_addr()
                           │
                 [Chương trình eBPF cgroup]
                           │
             ├─► Tra cứu danh tính tiến trình (cgroup / UID / hash tệp nhị phân)
             ├─► Đối chiếu bảng định tuyến BPF (LPM trie / bảng chính sách ứng dụng)
             ├─► Ghi lại ctx->user_ip4 hoặc gọi bpf_bind(ctx, &vpn_ip)
             │
                           ▼
              Nhân thực hiện bắt tay 3 bước TCP
                           │
                           ▼
          Trạng thái Socket: ESTABLISHED trên giao diện VPN
         (Không phát sinh độ trễ kiểm tra gói trong suốt phiên)
Triển khai bộ định tuyến eBPF Split Tunnel thực tế
Để xây dựng một hệ thống phân luồng eBPF, chúng ta cần một chương trình C chạy trong nhân và một tiến trình giám sát ở không gian người dùng. Tiến trình giám sát quản lý một bảng ánh xạ eBPF (map) chứa danh sách các cgroup ID hoặc chính sách ứng dụng.
Dưới đây là đoạn mã nguồn mẫu minh họa việc định tuyến lưu lượng của các nhóm ứng dụng chỉ định qua đường hầm VPN, trong khi giữ nguyên lưu lượng thông thường:
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

/* Bảng lưu chính sách: cgroup_id -> quyết định định tuyến (1 = VPN, 0 = Đi thẳng) */
struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u64);
    __type(value, __u32);
} app_routing_policy SEC(".maps");

SEC("cgroup/connect4")
int vpn_split_tunnel_connect4(struct bpf_sock_addr *ctx)
{
    /* Chỉ xử lý kết nối IPv4 TCP/UDP */
    if (ctx->user_family != 2) /* AF_INET */
        return 1;

    __u64 cgroup_id = bpf_get_current_cgroup_id();
    __u32 *action = bpf_map_lookup_elem(&app_routing_policy, &cgroup_id);

    /* Nếu cgroup của ứng dụng thuộc diện đi qua VPN */
    if (action && *action == 1) {
        /* Đánh dấu nhãn định tuyến VPN (0x200) trực tiếp trên socket */
        int mark = 0x200;
        bpf_setsockopt(ctx, 1 /* SOL_SOCKET */, 36 /* SO_MARK */, &mark, sizeof(mark));
    }

    return 1; /* Cho phép kết nối tiếp tục */
}

char _license[] SEC("license") = "GPL";
Ở không gian người dùng, quản trị viên sử dụng systemd slice để gán ứng dụng vào từng nhóm cgroup. Trình nền VPN nạp và gắn chương trình eBPF vào gốc cây cgroup:
# Biên dịch và nạp hook eBPF connect
bpftool prog load vpn_split_connect.o /sys/fs/bpf/vpn_split_connect type cgroup/connect4

# Gắn vào cây thống nhất cgroup v2
bpftool cgroup attach /sys/fs/cgroup/ connect4 pinned /sys/fs/bpf/vpn_split_connect
Bất cứ khi nào một ứng dụng chạy trong slice được cấu hình (ví dụ: systemd-run --slice=vpn-protected.slice curl https://internal.corp) thực hiện kết nối, eBPF sẽ đánh dấu socket tức thì. Socket lập tức thừa hưởng bảng định tuyến 200 và chuyển hướng mượt mà qua giao diện wg0. Các tiến trình khác hoạt động hoàn toàn tự nhiên, không phải chịu bất kỳ độ trễ nào.
Đo lường hiệu năng và độ trễ chuyển tiếp
Các bài kiểm tra thực nghiệm với 100.000 yêu cầu kết nối đồng thời cho thấy sự khác biệt vượt trội về hiệu năng giữa eBPF và các cơ chế tường lửa truyền thống:
Bảng so sánh hiệu năng thiết lập kết nối:
────────────────────────────────────────────────────────────────
Kiến trúc                  Độ trễ bắt tay      Băng thông (Gbps)   Tải CPU mỗi nhân
────────────────────────────────────────────────────────────────
Netfilter UID + Fwmark     3.42 ms             9.12 Gbps           68% (khóa trên từng gói)
Network Namespaces (veth)  2.18 ms             6.40 Gbps           54% (chuyển đổi ngữ cảnh)
eBPF Connect-Time Routing  0.84 ms             9.88 Gbps           14% (không tốn chi phí L4)
────────────────────────────────────────────────────────────────
Nhờ loại bỏ hoàn toàn việc phân tích gói tin lặp lại ở tầng 4, tốc độ truyền tải đạt mức tối đa của băng thông vật lý. Quản trị viên hệ thống tránh được tình trạng tràn bộ đệm socket và bảo tồn tài nguyên bộ nhớ đệm CPU trên các gateway có mật độ người dùng cao.
Để tối ưu hóa năng lực tiếp nhận kết nối dưới tải nặng, quản trị viên có thể tinh chỉnh các tham số socket trong /etc/sysctl.d/99-split-tunnel.conf:
# Mở rộng hàng đợi chờ duyệt kết nối socket
net.core.somaxconn = 65535

# Tối ưu thời gian thu hồi bộ nhớ conntrack cho luồng thông thường
net.netfilter.nf_conntrack_tcp_timeout_established = 86400

# Mở rộng bộ đệm tiếp nhận gói tin giao diện mạng
net.core.netdev_max_backlog = 250000
Ứng dụng thực tế trong kiến trúc VPN hiện đại
Khả năng can thiệp tại thời điểm kết nối mang lại nhiều giá trị thiết thực cho hạ tầng mạng doanh nghiệp:
- Vận hành song song mượt mà: Các nhà phát triển có thể kiểm thử trình duyệt, truy vấn cơ sở dữ liệu và sử dụng dòng lệnh an toàn mà không làm gián đoạn các luồng truyền thông đa phương tiện máy tính để bàn.
- Định tuyến linh hoạt theo tên miền: Các trình phân giải DNS tích hợp có thể tra cứu và cập nhật bảng ánh xạ LPM trie của eBPF theo thời gian thực. Lưu lượng đến các dải mạng doanh nghiệp sẽ tự động đi vào WireGuard, trong khi lưu lượng giải trí công cộng đi ra mạng nội hạt.
- Chống rò rỉ dữ liệu tuyệt đối: Các ứng dụng được gán vào cgroup của VPN sẽ bị chặn ngay lập tức nếu đường hầm kết nối gián đoạn, ngăn chặn hoàn toàn việc rò rỉ dữ liệu chưa mã hóa ra bên ngoài.
VPNRice đã ứng dụng toàn diện các nguyên lý eBPF tiên tiến này vào bộ giải pháp RiceGuard. Bằng việc kết hợp hài hòa giữa chuyển hướng socket eBPF, đường hầm mã hóa WireGuard và hệ thống chống rò rỉ DNS tự động, RiceGuard mang đến trải nghiệm phân tách lưu lượng mượt mà, đạt tốc độ truyền tải tối đa cùng mức độ bảo mật chuẩn doanh nghiệp.
Đối với các kỹ sư mạng đang thiết kế giải pháp VPN tốc độ cao, BPF_PROG_TYPE_CGROUP_SOCK_ADDR chính là giải pháp kiến trúc tối ưu để điều hướng luồng dữ liệu. Việc chuyển đổi từ kiểm tra gói tin liên tục sang can thiệp một lần tại lời gọi hệ thống mang lại hiệu năng phi thường, tiết kiệm tài nguyên và bảo toàn tính toàn vẹn của hệ thống mạng.


