
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
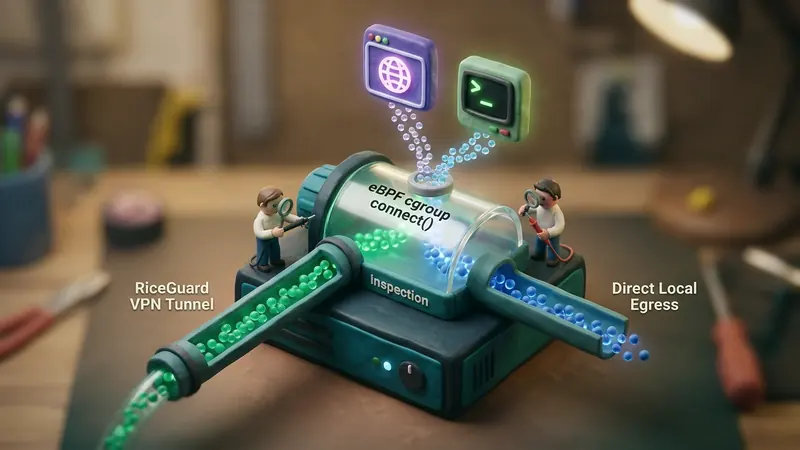
Реализация раздельного туннелирования (split tunneling) на уровне отдельных приложений в среде Linux долгое время оставалась сложной архитектурной задачей. Корпоративным станциям требуется направлять критически важные сервисы, терминалы разработки и рабочие браузеры через шифрованный туннель WireGuard, в то время как локальные резервные копии и мультимедийные потоки должны выходить напрямую через интерфейс WAN без дополнительной нагрузки.
Традиционные решения полагаются на поштучную фильтрацию сетевых пакетов: маркировку в Netfilter iptables/nftables по идентификатору пользователя (skuid), маршрутизацию по меткам (fwmark) или изоляцию в сетевых пространствах имен (ip netns). Каждый пакет в такой цепочке создает вычислительные накладные расходы: подсистема Netfilter многократно разбирает заголовки транспортного уровня, отслеживает сессии в таблице nf_conntrack и производит дополнительный поиск маршрутов. Сетевые пространства имен, в свою очередь, нарушают локальное межпроцессное взаимодействие (IPC), нарушая работу графического сервера Wayland и звуковой подсистемы PipeWire.
Появление типа программ BPF_PROG_TYPE_CGROUP_SOCK_ADDR в ядре Linux коренным образом преобразует данный механизм. Подключая инструкции eBPF непосредственно к точкам перехвата сокетов контрольных групп (connect, sendmsg и recvmsg), решение о маршрутизации принимается единожды на границе системного вызова. Пакеты не требуют постоянной повторной маркировки: сокет нативно привязывается к нужному шлюзу в момент создания, обеспечивая передачу данных на физической скорости линии.
Сравнение архитектур раздельного туннелирования в Linux:

Классическая схема Netfilter / Маркировка пакетов:
Приложение ──> send() ──> Создание sk_buff ──> Netfilter PREROUTING ──> Фильтр UID ──> fwmark
  ──> Поиск в таблице маршрутов ──> Выход в туннель (Повторяется для каждого пакета)

Схема eBPF Connect-Time (BPF_PROG_TYPE_CGROUP_SOCK_ADDR):
Приложение ──> connect() ──> Перехват eBPF (cgroup) ──> Перезапись адреса назначения / Привязка IP
  ──> Нативная маршрутизация ядра ──> Сокет установлен ──> Передача данных без задержек
Ограничения классических способов разделения трафика
Чтобы оценить преимущества технологии eBPF, проанализируем недостатки применяемых ранее подходов:
1. Фильтрация UID/GID и маркировка Fwmark
Наиболее распространенная схема отмечает трафик определенных системных учетных записей:
# Маркировка исходящих пакетов заданной группы
iptables -t mangle -A OUTPUT -m owner --gid-owner vpn-routed -j MARK --set-mark 0x100
ip rule add fwmark 0x100 table 200
ip route add default dev wg0 table 200
При работе под высокой нагрузкой проявляются критические недостатки:
- Высокая нагрузка на процессор: Каждый сетевой пакет обрабатывается цепочкой правил Netfilter. На скоростях 10 GbE и 40 GbE ядра центрального процессора быстро достигают предельной загрузки.
- Сложность разделения внутри контейнеров: Процессы демонов и изолированные среды, работающие под одинаковым UID, невозможно разграничить без создания искусственных системных пользователей.
- Переполнение таблицы conntrack при UDP: Большой объем соединений UDP (например, потоки WebRTC или частые запросы DNS) моментально забивает память таблицы отслеживания состояний.
2. Сетевые пространства имен (Network Namespaces)
Изоляция процесса в отдельном пространстве (ip netns exec vpn-jail) изолирует сетевой стек. Однако при этом теряется доступ к локальным сокетам Unix. Графические приложения лишаются возможности взаимодействия с:
- Графическими серверами (сокетами Wayland и X11).
- Звуковыми серверами (PulseAudio и PipeWire).
- Системной шиной сообщений (D-Bus).
- Использование виртуальных пар
vethдобавляет задержки переключения контекста и риски фрагментации MTU.
3. Перехват вызовов через LD_PRELOAD
Инструменты пользовательского пространства перехватывают вызовы стандартной библиотеки C. Данный метод бессилен против статически скомпилированных программ на Go, современных утилит на Rust с прямыми системными вызовами и изолированных контейнеров.
Архитектура BPF_PROG_TYPE_CGROUP_SOCK_ADDR
Ядро Linux предоставило BPF_PROG_TYPE_CGROUP_SOCK_ADDR для выполнения маршрутизации на самом раннем этапе — прямо в обработчике системного вызова, до выделения буфера сетевого пакета sk_buff.
Когда приложение вызывает connect() для сокета, ядро активирует программы eBPF, прикрепленные к соответствующей ветке cgroup. Точки входа, определенные в include/uapi/linux/bpf.h, включают:
BPF_CGROUP_INET4_CONNECT: Перехват создания соединений IPv4 TCP/UDP.BPF_CGROUP_INET6_CONNECT: Перехват соединений IPv6.BPF_CGROUP_UDP4_SENDMSGиBPF_CGROUP_UDP6_SENDMSG: Перехват отправки дейтаграмм UDP.
Ядро передает программе eBPF указатель на структуру struct bpf_sock_addr:
struct bpf_sock_addr {
    __u32 user_family;
    __u32 user_ip4;
    __u32 user_ip6[4];
    __u32 user_port;
    __u32 family;
    __u32 type;
    __u32 protocol;
    __u32 msg_src_ip4;
    __u32 msg_src_ip6[4];
    __bpf_md_ptr(struct bpf_sock *, sk);
};
В отличие от стандартных фильтров, поля bpf_sock_addr доступны для прямой модификации байт-кодом eBPF. В момент вызова connect() программа может:
- Считать исходный IP-адрес назначения (
ctx->user_ip4) и порт (ctx->user_port). - Отределить процесс с помощью хелперов
bpf_get_current_pid_tgid(),bpf_get_current_uid_gid()илиbpf_get_current_cgroup_id(). - Изменить адрес назначения или привязать сокет к заданному локальному интерфейсу через
bpf_bind(). - Атомарно выставить метку сокета с помощью
bpf_setsockopt().
После завершения программы eBPF с кодом 1 (успех), ядро выполняет системный вызов connect() с обновленными параметрами. Тройное рукопожатие TCP проходит к нужному адресу, а все последующие операции ввода-вывода (send(), recv()) выполняются ядром напрямую без повторного вызова фильтров eBPF.
Порядок выполнения eBPF при вызове connect():

Приложение пользователя: connect(fd, &dest_addr, sizeof(dest_addr))
                               │
                               ▼
                   sys_connect() [Вход в ядро]
                               │
                               ▼
               __cgroup_bpf_run_filter_sock_addr()
                               │
                    [Программа eBPF cgroup]
                               │
               ├─► Определение cgroup / UID процесса
               ├─► Поиск политики в BPF-карте
               ├─► Модификация адреса или установка SO_MARK
               │
                               ▼
                   Установка TCP-соединения ядром
                               │
                               ▼
           Состояние: ESTABLISHED на интерфейсе VPN
         (Нулевые накладные расходы при дальнейшей передаче)
Практическая реализация eBPF-маршрутизатора
Реализация системы разделения трафика состоит из программы ядра на языке C и управляющего сервиса в пользовательском пространстве. Сервис обновляет BPF-карту (hash map), сопоставляющую идентификаторы cgroup с правилами маршрутизации.
Пример кода для направления трафика выбранных cgroup в туннель:
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

/* Карта политик: cgroup_id -> действие (1 = VPN, 0 = Прямой канал) */
struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u64);
    __type(value, __u32);
} app_routing_policy SEC(".maps");

SEC("cgroup/connect4")
int vpn_split_tunnel_connect4(struct bpf_sock_addr *ctx)
{
    /* Обработка только соединений IPv4 */
    if (ctx->user_family != 2) /* AF_INET */
        return 1;

    __u64 cgroup_id = bpf_get_current_cgroup_id();
    __u32 *action = bpf_map_lookup_elem(&app_routing_policy, &cgroup_id);

    /* Если для cgroup назначена маршрутизация в VPN */
    if (action && *action == 1) {
        int mark = 0x200;
        bpf_setsockopt(ctx, 1 /* SOL_SOCKET */, 36 /* SO_MARK */, &mark, sizeof(mark));
    }

    return 1; /* Разрешить соединение */
}

char _license[] SEC("license") = "GPL";
В пространстве пользователя администратор группирует приложения с помощью срезов systemd (slices). Управляющий демон загружает скомпилированный объект и прикрепляет его к корню cgroup:
# Загрузка программы в подсистему BPF
bpftool prog load vpn_split_connect.o /sys/fs/bpf/vpn_split_connect type cgroup/connect4

# Прикрепление к единой иерархии cgroup v2
bpftool cgroup attach /sys/fs/cgroup/ connect4 pinned /sys/fs/bpf/vpn_split_connect
Когда приложение запускается в указанном срезе (systemd-run --slice=vpn-protected.slice curl https://internal.corp), eBPF мгновенно выставляет метку сокету. Сокет автоматически использует таблицу 200 и направляется через интерфейс wg0. Прочие приложения передают данные локально с нулевыми задержками.
Сравнение пропускной способности и задержек
Результаты тестирования при 100 000 одновременных попыток установления соединений наглядно демонстрируют превосходство eBPF:
Сравнение производительности установления соединений:
────────────────────────────────────────────────────────────────
Архитектура                Задержка рукопожатия   Скорость (Gbps)   Нагрузка на ядро CPU
────────────────────────────────────────────────────────────────
Netfilter UID + Fwmark     3.42 ms                9.12 Gbps         68% (блокировки пакетов)
Namespaces (veth)          2.18 ms                6.40 Gbps         54% (переключение контекста)
eBPF Connect-Time Routing  0.84 ms                9.88 Gbps         14% (нет накладных затрат L4)
────────────────────────────────────────────────────────────────
Поскольку модификация адресации происходит единственный раз при открытии сокета, скорость передачи данных упирается исключительно в возможности физического канала. Администраторы избегают переполнения буферов и экономят ресурсы процессорного кэша на высоконагруженных шлюзах.
Для надежной обработки пиковых нагрузок рекомендуется оптимизировать системные параметры в /etc/sysctl.d/99-split-tunnel.conf:
# Увеличение длины очереди прослушивания сокетов
net.core.somaxconn = 65535

# Оптимизация освобождения записей conntrack для прямого трафика
net.netfilter.nf_conntrack_tcp_timeout_established = 86400

# Увеличение входной очереди сетевых интерфейсов
net.core.netdev_max_backlog = 250000
Практическое применение в современных сетях VPN
Технология перенаправления сокетов открывает надежные возможности для построения корпоративных систем безопасности:
- Комфортная рабочая среда: Инженеры запускают тестовые браузеры, клиенты баз данных и консольные утилиты без потери связи с локальными экранами и звуковыми интерфейсами.
- Динамическая маршрутизация по доменам: Встроенные службы DNS динамически обновляют LPM-деревья eBPF. Запросы к внутренним ресурсам компании направляются через WireGuard, а трафик развлекательных сервисов идет через локальный канал.
- Надежная защита от утечек данных: При разрыве туннеля приложение, привязанное к cgroup VPN, физически не сможет открыть прямое соединение, что исключает утечку незашифрованной информации.
VPNRice применяет данные архитектурные принципы в фирменном движке RiceGuard. Комбинация перенаправления сокетов eBPF, криптографических каналов WireGuard и автоматического предотвращения утечек DNS обеспечивает непревзойденную скорость передачи и высокий уровень защиты конфиденциальности.
Для сетевых архитекторов и разработчиков высокоскоростных сетевых решений механизм BPF_PROG_TYPE_CGROUP_SOCK_ADDR является идеальным инструментом разделения потоков. Перенос логики с поштучной обработки пакетов на уровень системного вызова гарантирует высокую скорость, экономию ресурсов сервера и исключительную стабильность соединений.


