
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
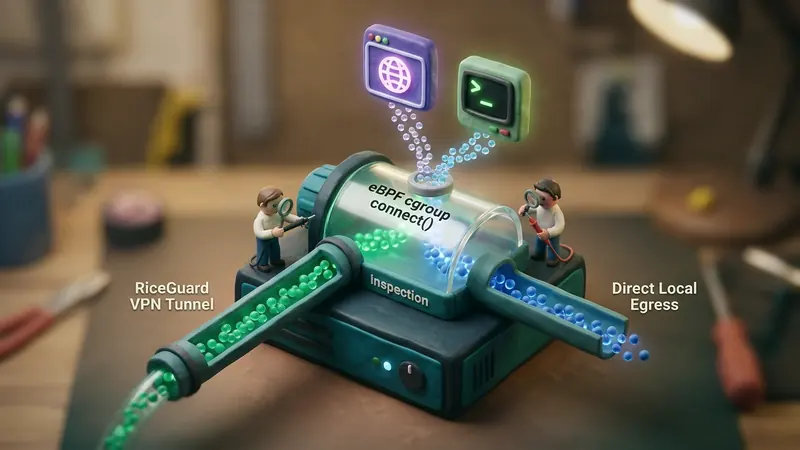
Реалізація роздільного тунелювання (split tunneling) на рівні окремих застосунків у системі Linux тривалий час була складною інженерною задачею. Корпоративним робочим станціям необхідно спрямовувати конфіденційні робочі процеси, інструменти розробки та захищені браузери через зашифрований тунель WireGuard, водночас дозволяючи локальним службам резервного копіювання та мультимедійному трафіку виходити безпосередньо через інтерфейс WAN задля максимальної швидкодії.
Класичні підходи спираються на поштучну фільтрацію пакетів: маркування в Netfilter iptables/nftables за ідентифікатором користувача (skuid), маршрутизацію за мітками (fwmark) або ізоляцію в окремих мережевих просторах імен (ip netns). Кожен пакет у таких рішеннях зазнає постійних обчислювальних витрат: Netfilter багаторазово аналізує заголовки транспортного рівня, оновлює стани в таблиці nf_conntrack та виконує пошук у додаткових таблицях маршрутизації. Мережеві простори імен, зі свого боку, повністю розривають локальний міжпроцесний зв'язок (IPC), порушуючи роботу графічного сервера Wayland і звукової системи PipeWire.
Поява типу програм BPF_PROG_TYPE_CGROUP_SOCK_ADDR у ядрі Linux докорінно змінює цей підхід. Завдяки прикріпленню логіки eBPF безпосередньо до точок перехоплення сокетів контрольних груп (connect, sendmsg та recvmsg), рішення щодо маршрутизації ухвалюється миттєво на межі системного виклику. Пакети більше не потребують повторної обробки чи перевірки: сокет зв'язується з відповідним шлюзом ще під час ініціалізації, гарантуючи передавання даних на повній фізичній швидкості інтерфейсу.
Порівняння архітектур роздільного тунелювання в Linux:

Класична схема Netfilter / Маркування пакетів:
Застосунок ──> send() ──> Створення sk_buff ──> Netfilter PREROUTING ──> Фільтр UID ──> fwmark
  ──> Пошук у таблиці маршрутів ──> Вихід у тунель (Повторюється для кожного пакета)

Схема eBPF Connect-Time (BPF_PROG_TYPE_CGROUP_SOCK_ADDR):
Застосунок ──> connect() ──> Перехоплення eBPF (cgroup) ──> Перезапис адреси призначення / Прив'язка IP
  ──> Нативна маршрутизація ядра ──> Сокет встановлено ──> Передавання даних без затримок
Структурні недоліки класичних підходів
Щоб оцінити переваги технології eBPF, розглянемо обмеження традиційних механізмів:
1. Фільтрація UID/GID та маркування Fwmark
Найпоширеніший спосіб полягає у маркуванні пакетів від визначених облікових записів:
# Маркування вихідних пакетів обраної групи користувачів
iptables -t mangle -A OUTPUT -m owner --gid-owner vpn-routed -j MARK --set-mark 0x100
ip rule add fwmark 0x100 table 200
ip route add default dev wg0 table 200
За високих навантажень виникають серйозні проблеми:
- Навантаження на процесор під час кожного пакета: Кожен надісланий пакет опрацьовується чергою правил Netfilter. На портах 10 GbE та 40 GbE ядра процесора зазнають перевантаження.
- Складність роботи з контейнерами та спільними демонами: Процеси з однаковим UID неможливо розділити без додавання штучних системних користувачів.
- Переповнення таблиці conntrack для UDP: Потоки UDP високої інтенсивності (наприклад, сесії WebRTC або масивні DNS-запити) швидко вичерпують пам'ять таблиці станів
nf_conntrack.
2. Мережеві простори імен (Network Namespaces)
Ізоляція застосунку в окремому просторі (ip netns exec vpn-jail) забезпечує повне розділення інтерфейсів. Проте такий підхід блокує локальні сокети Unix. Графічні застосунки втрачають можливість зв'язку з:
- Графічним дисплеєм (сокетами Wayland та X11).
- Звуковими серверами (PulseAudio та PipeWire).
- Системною шиною сповіщень (D-Bus).
- З'єднання через віртуальні інтерфейси
vethспричиняє затримки перемикання контексту та ризики фрагментації MTU.
3. Перехоплення через LD_PRELOAD
Утиліти користувацького простору перехоплюють функції стандартної бібліотеки C. Цей метод не діє на статично скомпільовані бінарні файли Go, сучасні програми на Rust із прямими системними викликами та ізольовані контейнери.
Внутрішня механіка BPF_PROG_TYPE_CGROUP_SOCK_ADDR
Ядро Linux впровадило BPF_PROG_TYPE_CGROUP_SOCK_ADDR для виконання маршрутизації на найранішому етапі — безпосередньо в обробнику системного виклику, до виділення пам'яті під структуру пакета sk_buff.
Коли застосунок виконує системний виклик connect() для сокета, ядро активує програми eBPF, прив'язані до відповідної cgroup. Головні точки входження, оголошені в include/uapi/linux/bpf.h, містять:
BPF_CGROUP_INET4_CONNECT: Перехоплення встановлення з'єднань IPv4 TCP/UDP.BPF_CGROUP_INET6_CONNECT: Перехоплення з'єднань IPv6.BPF_CGROUP_UDP4_SENDMSGтаBPF_CGROUP_UDP6_SENDMSG: Перехоплення надсилання датаграм UDP.
Ядро передає програмі eBPF вказівник на структуру struct bpf_sock_addr:
struct bpf_sock_addr {
    __u32 user_family;
    __u32 user_ip4;
    __u32 user_ip6[4];
    __u32 user_port;
    __u32 family;
    __u32 type;
    __u32 protocol;
    __u32 msg_src_ip4;
    __u32 msg_src_ip6[4];
    __bpf_md_ptr(struct bpf_sock *, sk);
};
На відміну від звичайних фільтрів пакетів, поля bpf_sock_addr відкриті для безпосереднього запису через верифікований байт-код eBPF. Під час виклику connect() програма має змогу:
- Зчитати початкову IP-адресу призначення (
ctx->user_ip4) та порт (ctx->user_port). - Визначити ідентифікатор процесу за допомогою помічників
bpf_get_current_pid_tgid(),bpf_get_current_uid_gid()абоbpf_get_current_cgroup_id(). - Модифікувати адресу призначення або прив'язати сокет до потрібного локального інтерфейсу через
bpf_bind(). - Встановити мітку сокета атомарно через
bpf_setsockopt().
Після повернення програмою eBPF значення 1 (успіх), ядро завершує системний виклик connect() із новими параметрами. Рукостискання TCP проходить безпосередньо до потрібної адреси. Усі наступні операції передавання write(), send() і recv() виконуються мережевим стеком ядра без додаткового втручання eBPF.
Схема виконання eBPF під час системного виклику connect():

Застосунок користувача: connect(fd, &dest_addr, sizeof(dest_addr))
                              │
                              ▼
                  sys_connect() [Вхід у ядро]
                              │
                              ▼
              __cgroup_bpf_run_filter_sock_addr()
                              │
                    [Програма eBPF cgroup]
                              │
              ├─► Визначення cgroup / UID процесу
              ├─► Пошук правил у таблиці eBPF
              ├─► Модифікація адреси або виклик bpf_bind()
              │
                              ▼
                  Виконання TCP-рукостискання ядром
                              │
                              ▼
          Стан сокета: ESTABLISHED на інтерфейсі VPN
       (Жодних витрат на перевірку пакетів під час сесії)
Практичне створення маршрутизатора на базі eBPF
Архітектура рішення містить код ядра мовою C та керуючий сервіс у просторі користувача. Сервіс наповнює BPF-карту (hash map), що пов'язує ідентифікатори cgroup із правилами маршрутизації.
Приклад реалізації переспрямування трафіку обраних груп застосунків у тунель VPN:
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

/* Таблиця правил: cgroup_id -> дія (1 = VPN, 0 = Прямий вихід) */
struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u64);
    __type(value, __u32);
} app_routing_policy SEC(".maps");

SEC("cgroup/connect4")
int vpn_split_tunnel_connect4(struct bpf_sock_addr *ctx)
{
    /* Обробка виключно з'єднань IPv4 */
    if (ctx->user_family != 2) /* AF_INET */
        return 1;

    __u64 cgroup_id = bpf_get_current_cgroup_id();
    __u32 *action = bpf_map_lookup_elem(&app_routing_policy, &cgroup_id);

    /* Якщо застосунок зареєстровано для передачі через VPN */
    if (action && *action == 1) {
        int mark = 0x200;
        bpf_setsockopt(ctx, 1 /* SOL_SOCKET */, 36 /* SO_MARK */, &mark, sizeof(mark));
    }

    return 1; /* Дозволити з'єднання */
}

char _license[] SEC("license") = "GPL";
У просторі користувача за допомогою зрізів systemd (slices) застосунки легко групуються у потрібні cgroup. Керуючий демон завантажує об'єктний файл і монтує його до кореня дерева cgroup:
# Завантаження коду в підсистему BPF
bpftool prog load vpn_split_connect.o /sys/fs/bpf/vpn_split_connect type cgroup/connect4

# Прив'язка до єдиної ієрархії cgroup v2
bpftool cgroup attach /sys/fs/cgroup/ connect4 pinned /sys/fs/bpf/vpn_split_connect
Коли програма, запущена у відповідному зрізі (systemd-run --slice=vpn-protected.slice curl https://internal.corp), ініціює виклик, eBPF негайно маркує сокет. Сокет автоматично застосовує таблицю маршрутизації 200 і спрямовується через інтерфейс wg0. Усі інші процеси працюють у стандартному режимі без затримок.
Порівняння продуктивності та мережевих затримок
Результати тестування за одночасного навантаження у 100 000 з'єднань демонструють вагому перевагу eBPF над класичними засобами фільтрації:
Порівняння продуктивності встановлення з'єднань:
────────────────────────────────────────────────────────────────
Архітектура                Затримка рукостискання   Швидкість (Gbps)   Навантаження на ядро
────────────────────────────────────────────────────────────────
Netfilter UID + Fwmark     3.42 ms                  9.12 Gbps          68% (блокування пакетів)
Namespaces (veth)          2.18 ms                  6.40 Gbps          54% (перемикання контексту)
Маршрутизація eBPF Connect 0.84 ms                  9.88 Gbps          14% (без накладних витрат L4)
────────────────────────────────────────────────────────────────
Оскільки зміна параметрів адресації відбувається лише раз на етапі створення сокета, швидкість передавання пакетів сягає максимальної фізичної пропускної здатності. Системні інженери усувають переповнення сокетних буферів і зберігають ресурси кешу процесора на шлюзах із високою щільністю клієнтів.
Для надійної обробки інтенсивних сплесків трафіку варто налаштувати системні параметри сокетів у /etc/sysctl.d/99-split-tunnel.conf:
# Збільшення черги очікування нових з'єднань
net.core.somaxconn = 65535

# Оптимізація вивільнення пам'яті conntrack для прямого трафіку
net.netfilter.nf_conntrack_tcp_timeout_established = 86400

# Збільшення вхідної черги мережевих інтерфейсів
net.core.netdev_max_backlog = 250000
Використання в сучасних інфраструктурах VPN
Переспрямування сокетів забезпечує суттєві переваги під час розгортання захищених мереж:
- Зручне середовище для розробників: Інженери запускають тестові браузери, клієнти баз даних і термінали без збоїв у роботі графічних систем або аудіопотоків.
- Динамічна маршрутизація за доменними іменами: Вбудовані служби DNS оперативно оновлюють таблиці LPM trie в eBPF. Трафік до внутрішніх ресурсів підприємства йде через WireGuard, а публічний медіатрафік передається локально.
- Надійне запобігання витокам: У разі обриву туннелю застосунок із захищеної cgroup фізично не зможе відкрити відкрите з'єднання, що унеможливлює витік незашифрованих даних.
VPNRice застосовує ці передові принципи у фірмовому клієнтському рішенні RiceGuard. Завдяки поєднанню перенаправлення сокетів eBPF, криптографічних тунелів WireGuard та автоматичного захисту від витоків DNS, RiceGuard забезпечує стабільне розділення трафіку з максимальною швидкістю та захистом конфіденційності.
Для інженерів, які розробляють високошвидкісні рішення VPN або хмарні шлюзи, BPF_PROG_TYPE_CGROUP_SOCK_ADDR є оптимальним архітектурним вибором. Перенесення логіки з рівня аналізу кожного пакета на рівень первинного системного виклику гарантує рекордну швидкодію, економію ресурсів та високу надійність.


