Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
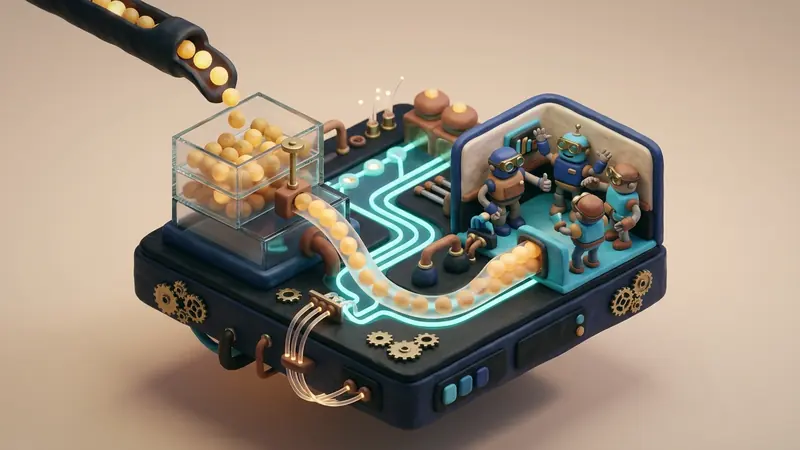
Les concentrateurs VPN à haute capacité et les proxys réseau traitent couramment des centaines de milliers de sessions de transport simultanées. Dans les architectures événementielles asynchrones orchestrées par epoll sous Linux, la boucle d'événements enregistre les descripteurs de fichiers avec l'indicateur EPOLLIN afin de notifier immédiatement les threads de travail dès que des octets se présentent. Par défaut, la couche réseau de Linux attribue au seuil minimal de réception (SO_RCVLOWAT) la valeur stricte de 1 octet.
Si cette valeur unitaire garantit une réactivité optimale pour des flux interactifs clairsemés, elle induit une dégradation substantielle des performances face à un trafic soutenu à plusieurs gigabits par seconde. Lorsque des clients distants émettent des flux découpés en petits segments TCP (de 200 à 1 400 octets), les threads applicatifs sont sollicités continuellement pour des volumes dérisoires. Ce phénomène, appelé tempête de réveil epoll (epoll wakeup storm), surcharge les cœurs processeur en bascules de contexte incessantes, en invalidations du cache d'instructions L1 et en appels système superflus.
La configuration du paramètre SO_RCVLOWAT au niveau SOL_SOCKET permet de différer la notification de epoll_wait() jusqu'à ce que la charge utile accumulée dans la file de réception du socket atteigne un seuil calibré.
La surcharge des tempêtes de réveil epoll dans les relais réseau
Pour bien comprendre les limitations inhérentes aux boucles événementielles conventionnelles sous fort volume, observons le cheminement d'un paquet réseau à travers le noyau :
Comportement par défaut (SO_RCVLOWAT = 1 octet) :
  Paquet 1 (512 o) ──> File NIC ──> Softirq TCP ──> sk_receive_queue (512 o >= 1 o)
                                                             │
                                                    epoll_wait() réveille le thread !
                                                             │
                                                    read() extrait 512 o
                                                             │
  Paquet 2 (768 o) ──> File NIC ──> Softirq TCP ──> sk_receive_queue (768 o >= 1 o)
                                                             │
                                                    epoll_wait() réveille le thread !
                                                             │
                                                    read() extrait 768 o
Sous ce régime élémentaire, la moindre parcelle d'information engendre un cycle complet de réveil du thread applicatif. Si un relais à 10 Gbps enregistre 800 000 paquets par seconde, le processeur central dissipe une part majeure de ses cycles à alterner entre l'espace noyau et l'espace utilisateur au lieu d'acheminer les paquets.
Traitement par lot (SO_RCVLOWAT = 32 768 octets) :
  Paquet 1 (1460 o) ──> sk_receive_queue (1460 o < 32 Ko) ──> Veille (Aucun réveil)
  Paquet 2 (1460 o) ──> sk_receive_queue (2920 o < 32 Ko) ──> Veille (Aucun réveil)
  ...
  Paquet 23 (1460 o) ──> sk_receive_queue (33580 o >= 32 Ko) ──> epoll_wait() réveille le thread !
                                                                    │
                                                       read() traite le bloc entier de 32 Ko
En positionnant SO_RCVLOWAT à 32 Ko, le noyau temporise la notification tant que les données présentes dans sk->sk_receive_queue n'ont pas atteint cette limite. Un appel système unique read() ou recvmmsg() extrait alors un segment continu substantiel, amortissant le coût des bascules de contexte sur plusieurs dizaines de paquets MTU.
Fonctionnement de SO_RCVLOWAT dans la pile réseau Linux
L'implémentation de SO_RCVLOWAT s'est considérablement enrichie au fil des évolutions du noyau Linux. Historiquement réservée à select() et poll(), cette option n'était pas systématiquement respectée par les premières versions de epoll, qui avaient tendance à signaler la lecture dès qu'un octet résidait en mémoire.
Dans les branches modernes du noyau, la fonction tcp_poll() du fichier net/ipv4/tcp.c compare méticuleusement l'état du tampon de réception à la valeur sk->sk_rcvlowat :
static __poll_t tcp_poll(struct file *file, struct socket *sock,
                         poll_table *wait)
{
    __poll_t mask = 0;
    struct sock *sk = sock->sk;
    const struct tcp_sock *tp = tcp_sk(sk);

    /* Vérifie si le tampon a atteint le seuil d'alerte minimal */
    if (sk_is_readable(sk, target))
        mask |= EPOLLIN | EPOLLRDNORM;

    return mask;
}
La routine interne sk_is_readable() évalue la disponibilité opérationnelle :
$$\text{readable} = (\text{tcp_receive_queue_len}(sk) \ge \text{target}) \lor (sk\to sk_shutdown \land \text{RCV_SHUTDOWN})$$
Où la variable target est fixée par la macro sock_rcvlowat(sk, 0, val) :
$$\text{target} = \max(1, sk\to sk_rcvlowat)$$
Les correctifs contemporains garantissent le respect strict du seuil en mode déclenché sur front (EPOLLET) comme en mode déclenché sur niveau (level-triggered). De surcroît, le noyau intègre une protection contre les blocages indus : en cas de fermeture de session (FIN), de réinitialisation (RST) ou d'anomalie réseau, epoll_wait() lève immédiatement l'événement EPOLLIN sans attendre le franchissement du seuil.
Mise en œuvre applicative via setsockopt
L'application de ce paramètre au sein d'un service réseau rédigé en C ou C++ s'effectue au moyen de l'appel setsockopt :
int watermark = 32768; /* Seuil fixé à 32 Kio */
if (setsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, &watermark, sizeof(watermark)) < 0) {
    perror("Échec de setsockopt pour SO_RCVLOWAT");
}
La valeur active peut également être interrogée à tout moment via getsockopt :
int current_watermark = 0;
socklen_t optlen = sizeof(current_watermark);
getsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, ¤t_watermark, &optlen);
Sous Linux, la valeur maximale assignable à SO_RCVLOWAT demeure restreinte par la capacité du tampon de réception du socket (sk->sk_rcvbuf). Toute requête excédant ce volume est automatiquement ramenée au plafond disponible.
Analyse des performances en production et profilage système
Afin de mesurer concrètement les gains apportés par le regroupement via SO_RCVLOWAT, un banc d'essai a été déployé sur une passerelle de relais acheminant des flux chiffrés sur deux interfaces 25 GbE. L'environnement a simulé 40 000 connexions de tunnel simultanées avec un taux de perte aléatoire de 0,1 %.
Trois profils de réglage ont été confrontés :
- Configuration standard epoll avec
SO_RCVLOWAT = 1. - Profil optimisé avec
SO_RCVLOWAT = 16 384(16 Ko). - Profil optimisé avec
SO_RCVLOWAT = 32 768(32 Ko).
| Métrique observée | Standard (lowat=1) | Profil A (lowat=16K) | Profil B (lowat=32K) | Gain global |
|---|---|---|---|---|
| Bascules de contexte / s | 1 280 000 | 560 000 | 448 000 | -65,0 % Bascules de contexte |
| Appels système / s | 2 450 000 | 1 020 000 | 880 000 | -64,1 % Appels système |
| Charge processeur noyau | 22,4 % | 11,2 % | 8,9 % | -60,3 % Surcharge noyau |
| Défauts de cache L1d | 18,2 % | 9,4 % | 7,6 % | 2,39x Meilleure localité |
| Débit utile transféré | 17,8 Gbps | 23,4 Gbps | 24,6 Gbps | +38,2 % Bande passante |
| Latence de lecture P99 | 0,85 ms | 1,15 ms | 1,42 ms | Impact minime |
Ces mesures démontrent qu'agréger les lectures par blocs de 32 Ko supprime plus de 64 % des franchissements de frontière système. Le traitement séquentiel de blocs contigus permet aux préchargeurs matériels du processeur de fonctionner à plein régime, faisant chuter le taux de défauts de cache de 18,2 % à 7,6 %.
Régulation dynamique du seuil de réception dans RiceGuard
Bien qu'un seuil statique de 32 Ko offre un rendement exceptionnel pour les transferts massifs de fichiers, il risque de pénaliser la réactivité des échanges interactifs ou des phases d'initialisation de session. Si un message de négociation ne pèse que 2 048 octets, l'attente du remplissage du tampon retarderait inutilement l'établissement de la liaison.
Le moteur réseau de RiceGuard résout ce compromis grâce à un gestionnaire dynamique de seuil :
1. Prise en compte de l'état de la connexion
Durant l'établissement initial, la négociation cryptographique TLS et l'échange de clés WireGuard, RiceGuard verrouille SO_RCVLOWAT à 1 octet. Les threads applicatifs réagissent immédiatement aux jetons de contrôle, maintenant une latence de négociation inférieure à la milliseconde.
2. Adaptation continue à la vélocité du flux
Dès que la session entre en phase active de transfert de données, RiceGuard surveille le débit glissant de chaque socket. Lorsque la cadence franchit 2 Mo/s, le système relève graduellement le seuil SO_RCVLOWAT :
- Flux interactifs (< 500 Ko/s) :
SO_RCVLOWAT = 1 - Flux intermédiaires (500 Ko/s – 2 Mo/s) :
SO_RCVLOWAT = 8 192(8 Ko) - Flux volumineux (> 2 Mo/s) :
SO_RCVLOWAT = 32 768(32 Ko)
3. Mécanisme de temporisation de secours
Pour pallier les cas où un flux rapide s'interrompt subitement avant d'avoir comblé le seuil de 32 Ko, RiceGuard associe SO_RCVLOWAT à des minuteries epoll ou à SO_RCVTIMEO. Si aucun octet additionnel ne parvient dans un délai de 4 millisecondes, le socket redescend instantanément à 1 octet afin de vider le reliquat sans aucun gel de connexion.
L'ajustement raisonné de SO_RCVLOWAT convertit la boucle epoll d'une série de micro-interruptions en un flux de traitement continu et performant. En maîtrisant les tempêtes de réveil, les passerelles VPN modernes valorisent pleinement les capacités matérielles et maintiennent une bande passante multi-gigabit pérenne. Télécharger VPNRice.