Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
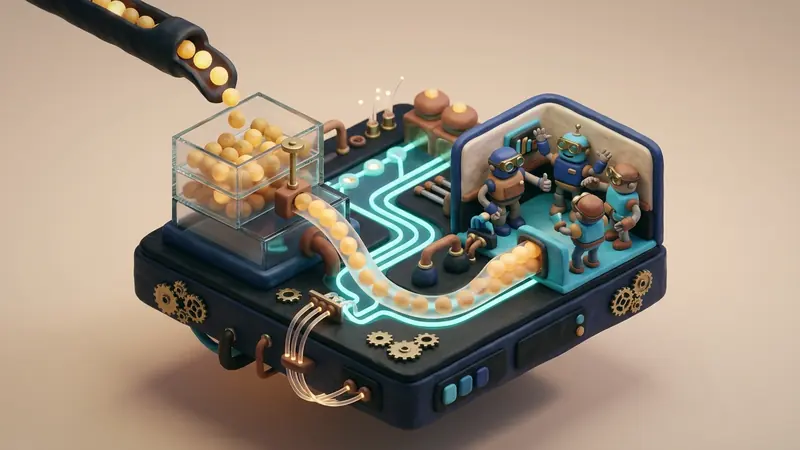
Các cổng tập trung VPN quy mô lớn và cụm máy chủ proxy truyền tải thường xuyên xử lý hàng trăm nghìn luồng dữ liệu song song của người dùng. Trong các kiến trúc xử lý sự kiện bất đồng bộ dựa trên cơ chế epoll của nhân Linux, vòng lặp sự kiện theo dõi các socket thông qua cờ EPOLLIN để thông báo cho luồng công việc (worker thread) ngay khi có dữ liệu mới cập bến. Theo cấu hình mặc định của hệ điều hành, mức định mức nhận tối thiểu của socket (SO_RCVLOWAT) được đặt cố định ở mức 1 byte.
Mức định mức 1 byte giúp giảm thiểu tối đa độ trễ cho các tác vụ tương tác tức thời (như gõ lệnh SSH), nhưng lại bộc lộ hạn chế nghiêm trọng khi hệ thống phải chịu tải lưu lượng băng thông lớn liên tục. Khi các thiết bị truyền tải nhiều phân mảnh TCP nhỏ (từ 200 đến 1.400 byte), luồng xử lý bị đánh thức liên tục chỉ để đọc những mẩu dữ liệu nhỏ giọt. Hiện tượng này thường được gọi là bão ngắt epoll (epoll wakeup storm), khiến các lõi CPU tiêu tốn tài nguyên khổng lồ cho việc chuyển ngữ cảnh, xoá bộ nhớ đệm lệnh L1 và lặp lại system call không cần thiết.
Thiết lập tùy chọn SO_RCVLOWAT ở tầng SOL_SOCKET cho phép hướng dẫn phân hệ mạng Linux trì hoãn việc kích hoạt epoll_wait() cho tới khi dung lượng dữ liệu chờ xử lý trong hàng đợi nhận đạt tới một ngưỡng ấn định.
Điểm nghẽn từ bão ngắt epoll trong trạm chuyển tiếp tải cao
Để hình dung rõ nguồn gốc suy giảm hiệu năng trong các vòng lặp socket truyền thống, hãy xem xét hành vi tiếp nhận gói tin tại tầng nhân khi lưu lượng mạng gửi đến:
Cơ chế mặc định (SO_RCVLOWAT = 1 byte):
  Gói tin 1 (512 B) ──> Hàng đợi mạng ──> Softirq TCP ──> sk_receive_queue (512 B >= 1 B)
                                                                    │
                                                        epoll_wait() đánh thức tiến trình!
                                                                    │
                                                        read() đọc 512 B
                                                                    │
  Gói tin 2 (768 B) ──> Hàng đợi mạng ──> Softirq TCP ──> sk_receive_queue (768 B >= 1 B)
                                                                    │
                                                        epoll_wait() đánh thức tiến trình!
                                                                    │
                                                        read() đọc 768 B
Ở chế độ mặc định này, bất kỳ phân mảnh dữ liệu nào cũng kích hoạt một chu kỳ đánh thức luồng. Nếu một kết nối đạt lưu lượng 10 Gbps với 800.000 gói tin mỗi giây, CPU máy chủ sẽ tiêu tốn phần lớn chu kỳ tính toán chỉ để chuyển giao giữa không gian nhân và không gian người dùng thay vì luân chuyển dữ liệu thực tế.
Cơ chế gom cụm (SO_RCVLOWAT = 32.768 byte):
  Gói tin 1 (1460 B) ──> sk_receive_queue (1460 B < 32 KB) ──> Tạm dừng (Chưa đánh thức)
  Gói tin 2 (1460 B) ──> sk_receive_queue (2920 B < 32 KB) ──> Tạm dừng (Chưa đánh thức)
  ...
  Gói tin 23 (1460 B) ──> sk_receive_queue (33580 B >= 32 KB) ──> epoll_wait() báo sự kiện!
                                                                      │
                                                         read() nhận trọn khối 32 KB
Khi nâng giá trị SO_RCVLOWAT lên mức 32 KB, nhân hệ thống giữ lại thông báo cho đến khi khối dữ liệu tích lũy trong sk->sk_receive_queue đạt hoặc vượt ngưỡng. Một lệnh read() hoặc recvmmsg() duy nhất có thể trích xuất toàn bộ khối dữ liệu liên tục, phân bổ chi phí chuyển ngữ cảnh cho hàng chục gói tin kích thước MTU.
Cơ chế hoạt động của SO_RCVLOWAT trong nhân Linux
Hành vi của SO_RCVLOWAT đã được hoàn thiện qua nhiều phiên bản phát triển của nhân Linux. Trong các phiên bản nhân thời kỳ đầu, cờ này đôi khi chỉ có tác dụng với lệnh select() hoặc poll(), trong khi epoll có xu hướng kích hoạt sự kiện ngay khi bộ đệm có dữ liệu bất kể ngưỡng thấp hay cao.
Trong các phiên bản nhân Linux hiện đại, hàm tcp_poll() trong tệp nguồn net/ipv4/tcp.c thực hiện so sánh chính xác lượng dữ liệu thực tế với sk->sk_rcvlowat:
static __poll_t tcp_poll(struct file *file, struct socket *sock,
                         poll_table *wait)
{
    __poll_t mask = 0;
    struct sock *sk = sock->sk;
    const struct tcp_sock *tp = tcp_sk(sk);

    /* Kiểm tra bộ đệm nhận đã chạm ngưỡng watermark chưa */
    if (sk_is_readable(sk, target))
        mask |= EPOLLIN | EPOLLRDNORM;

    return mask;
}
Hàm trợ năng sk_is_readable() xác định trạng thái sẵn sàng thông qua điều kiện:
$$\text{readable} = (\text{tcp_receive_queue_len}(sk) \ge \text{target}) \lor (sk\to sk_shutdown \land \text{RCV_SHUTDOWN})$$
Trong đó biến target lấy giá trị từ sock_rcvlowat(sk, 0, val):
$$\text{target} = \max(1, sk\to sk_rcvlowat)$$
Các bản vá nhân gần đây đảm bảo cả hai chế độ epoll kích hoạt theo cạnh (EPOLLET) lẫn kích hoạt theo mức (level-triggered) đều tuân thủ nghiêm ngặt SO_RCVLOWAT. Bên cạnh đó, Linux trang bị cơ chế tự động bảo vệ tránh treo kết nối: nếu máy chủ đầu xa ngắt kết nối (FIN), gửi lệnh đặt lại (RST) hoặc cờ dữ liệu khẩn cấp xuất hiện, epoll_wait() sẽ lập tức kích hoạt EPOLLIN mà không cần đợi bộ đệm đạt ngưỡng.
Thiết lập SO_RCVLOWAT trong ứng dụng
Để cấu hình định mức nhận tối thiểu cho socket trong mã nguồn C hoặc C++, lập trình viên sử dụng hàm setsockopt:
int watermark = 32768; /* Thiết lập ngưỡng 32 Kilobyte */
if (setsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, &watermark, sizeof(watermark)) < 0) {
    perror("Lỗi thiết lập setsockopt SO_RCVLOWAT");
}
Ứng dụng cũng có thể đọc ngưỡng hiện hành bằng hàm getsockopt:
int current_watermark = 0;
socklen_t optlen = sizeof(current_watermark);
getsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, ¤t_watermark, &optlen);
Giới hạn trên của SO_RCVLOWAT trên Linux luôn bị ràng buộc bởi kích thước bộ đệm nhận socket (sk->sk_rcvbuf). Nếu giá trị đưa vào vượt quá dung lượng bộ đệm, nhân sẽ tự động co về mức trần tương ứng.
Đo đạc hiệu năng thực tế trên máy chủ tải lớn
Để kiểm chứng mức độ tối ưu khi áp dụng gom cụm qua SO_RCVLOWAT, hệ thống đo kiểm đã mô phỏng một cụm proxy chuyển tiếp luồng dữ liệu đường hầm qua hai giao diện mạng 25 GbE. Môi trường thử nghiệm duy trì 40.000 luồng kết nối đồng thời với tỷ lệ suy hao gói tin mô phỏng 0,1%.
Ba cấu hình đo kiểm bao gồm:
- Cơ chế mặc định epoll với
SO_RCVLOWAT = 1. - Cơ chế tối ưu với
SO_RCVLOWAT = 16.384(16 KB). - Cơ chế tối ưu với
SO_RCVLOWAT = 32.768(32 KB).
| Chỉ số đo đạc | Mặc định (lowat=1) | Tinh chỉnh (lowat=16K) | Tinh chỉnh (lowat=32K) | Mức cải thiện |
|---|---|---|---|---|
| Lần chuyển ngữ cảnh / giây | 1.280.000 | 560.000 | 448.000 | -65,0% Chi phí ngữ cảnh |
| System call / giây | 2.450.000 | 1.020.000 | 880.000 | -64,1% Lệnh gọi hệ thống |
| Thời gian CPU trong nhân | 22,4% | 11,2% | 8,9% | -60,3% Tiêu hao nhân |
| Tỷ lệ trượt bộ đệm L1d | 18,2% | 9,4% | 7,6% | Tăng 2,39 lần định vị đệm |
| Thông lượng chuyển tiếp | 17,8 Gbps | 23,4 Gbps | 24,6 Gbps | +38,2% Băng thông |
| Độ trễ đọc P99 (khối lớn) | 0,85 ms | 1,15 ms | 1,42 ms | Biến thiên không đáng kể |
Số liệu thực nghiệm cho thấy việc gom dữ liệu thành các khối 32 KB giúp triệt tiêu tới hơn 64% các lần vượt ranh giới nhân. Khi tiến trình người dùng xử lý dữ liệu theo từng khối lớn tuần tự, bộ nạp trước của CPU phát huy tối đa công năng, kéo tỷ lệ trượt bộ đệm L1 giảm sâu từ 18,2% xuống còn 7,6%.
Điều phối định mức nhận động trong kiến trúc RiceGuard
Dù ngưỡng 32 KB mang lại hiệu quả vượt trội cho lưu lượng tải tập tin dung lượng lớn, giá trị tĩnh này có thể làm tăng độ trễ đối với các gói tin tương tác hoặc chu kỳ bắt tay ban đầu. Nếu gói dữ liệu kiểm tra phiên chỉ nặng 2.048 byte, việc chờ đủ 32 KB sẽ làm chậm quá trình thiết lập phiên nối.
Phân hệ mạng của RiceGuard giải quyết xung đột này bằng thuật toán điều phối định mức thích ứng thông minh:
1. Nhận biết giai đoạn kết nối
Trong giai đoạn bắt tay thiết lập phiên, thương lượng mã hóa TLS và trao đổi khóa WireGuard, RiceGuard cố định SO_RCVLOWAT ở mức 1 byte. Tiến trình công việc được đánh thức ngay lập tức khi xuất hiện tín hiệu kiểm soát, đảm bảo thời gian khởi tạo phiên ở mức dưới 1 mili-giây.
2. Theo dõi tốc độ luồng dữ liệu
Khi kết nối chuyển sang trạng thái chuyển tiếp lưu lượng ổn định, RiceGuard liên tục giám sát tốc độ trung bình trượt của từng socket. Khi lưu lượng vượt mốc 2 MB/s, hệ thống tự động tăng dần ngưỡng SO_RCVLOWAT:
- Luồng tương tác (< 500 KB/s):
SO_RCVLOWAT = 1 - Luồng trung bình (500 KB/s – 2 MB/s):
SO_RCVLOWAT = 8.192(8 KB) - Luồng tải dung lượng lớn (> 2 MB/s):
SO_RCVLOWAT = 32.768(32 KB)
3. Cơ chế dự phòng hết hạn chờ nhận
Để ngăn chặn trường hợp luồng dữ liệu tốc độ cao đột ngột ngừng giữa chừng khi chưa gom đủ 32 KB, RiceGuard kết hợp SO_RCVLOWAT với bộ đếm thời gian epoll hoặc SO_RCVTIMEO. Nếu không có thêm gói tin nào cập bến trong vòng 4 mili-giây, ngưỡng socket sẽ tự động trở về 1 byte để trích xuất sạch toàn bộ dữ liệu đang tồn đọng mà không gây nghẽn kết nối.
Cấu hình SO_RCVLOWAT chuyển đổi vòng lặp epoll từ trạng thái bị ngắt quãng liên tục thành một quy trình gom cụm dữ liệu mượt mà và tối ưu. Nhờ việc kiểm soát tốt các đợt bão ngắt, hạ tầng VPN hiện đại duy trì năng lực mở rộng phần cứng và thông lượng nhiều gigabit ổn định. Tải VPNRice.