Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
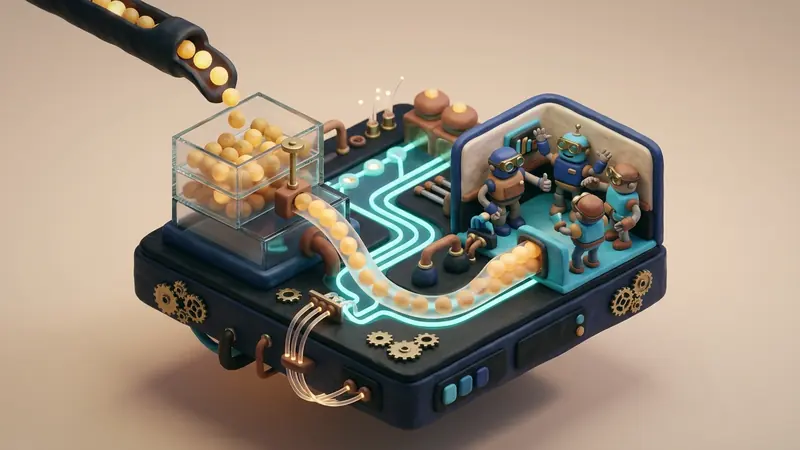
گیتویهای تجمیع VPN با ظرفیت بالا و پراکسیهای هدایت ترافیک لبه، روزانه صدها هزار جریان انتقال داده همزمان را مدیریت میکنند. در معماریهای ناهمگام مبتنی بر حلقه رخداد epoll در لینوکس، توصیفکنندههای فایل با پرچم EPOLLIN ثبت میشوند تا به محض ورود بایتهای داده، رشتههای پردازشی را برای خواندن مطلع سازند. به طور پیشفرض در لایه شبکه لینوکس، کمترین حد آستانه دریافت سوکت (SO_RCVLOWAT) دقیقا بر روی ۱ بایت تنظیم شده است.
اگرچه آستانه ۱ بایتی حداقل تاخیر را برای تبادلات کمحجم تعاملی فراهم میسازد، اما در جریانهای سنگین چند گیگابیتی موجب افت شدید بهرهوری میشود. هنگامی که کلاینتها بستههای خردشده TCP (بین ۲۰۰ تا ۱۴۰۰ بایت) ارسال میکنند، رشتههای پردازشی برای خواندن مقادیر بسیار ناچیز به طور مداوم بیدار میشوند. این وضعیت که به عنوان «طوفان بیداری epoll» شناخته میشود، هستههای پردازنده را با تعویض مکرر متن، تخلیه کش دستورالعملهای L1 و سربار فراخوانهای سیستمی بیثمر اشباع میکند.
تنظیم گزینه SO_RCVLOWAT در سطح SOL_SOCKET به پشته شبکه لینوکس دستور میدهد که اعلان بیداری epoll_wait() را تا زمان تجمیع حجم مشخصی از بایتها در صف دریافت سوکت به تعویق بیندازد.
چالش طوفان بیداری epoll در رلههای پرسرعت شبکه
برای درک بهتر گلوگاههای عملکردی در حلقههای سوکت سنتی تحت ترافیک سنگین، جریان پردازش دادهها در هسته لینوکس را مرور میکنیم:
رفتار پیشفرض هسته (SO_RCVLOWAT = 1 بایت):
بسته ۱ (512 بایت) ──> صف کارت شبکه ──> وقفه نرمافزاری ──> sk_receive_queue (512 >= 1)
│
epoll_wait رشته را بیدار میکند!
│
read مقدار 512 بایت را میخواند
│
بسته ۲ (768 بایت) ──> صف کارت شبکه ──> وقفه نرمافزاری ──> sk_receive_queue (768 >= 1)
│
epoll_wait رشته را بیدار میکند!
│
read مقدار 768 بایت را میخواند
تحت این سیاست اولیه، ورود هر قطعه کوچک شبکه یک چرخه بیداری کامل برای پردازشگر به وجود میآورد. چنانچه یک خط ارتباطی ۱۰ گیگابیت بر ثانیه پذیرای ۸۰۰ هزار بسته در ثانیه باشد، بخش بزرگی از توان پردازنده صرف تعویض فضا بین هسته و کاربر میشود و توان کمتری برای بازپخش بستهها باقی میماند.
رفتار دستهبندیشده (SO_RCVLOWAT = 32,768 بایت):
بسته ۱ (1460 بایت) ──> sk_receive_queue (1460 < 32 KB) ──> خواب (بدون بیداری)
بسته ۲ (1460 بایت) ──> sk_receive_queue (2920 < 32 KB) ──> خواب (بدون بیداری)
...
بسته ۲۳ (1460 بایت) ──> sk_receive_queue (33580 >= 32 KB) ──> epoll_wait رشته را بیدار میکند!
│
read کل بسته یکپارچه ۳۲ کیلوبایتی را میخواند
هنگامی که مقدار SO_RCVLOWAT به ۳۲ کیلوبایت افزایش مییابد، هسته لینوکس بایتهای ورودی را در صف سوکت ذخیره میکند تا به حدنصاب برسد. با این روش، تنها یک فراخوان read() یا recvmmsg() بلوکی بزرگ و متوالی را تخلیه کرده و هزینه جابجایی متن را میان دهها بسته تقسیم میکند.
سازوکار فنی SO_RCVLOWAT در پشته شبکه هسته لینوکس
سازوکار SO_RCVLOWAT در طول چرخههای توسعه لینوکس ارتقای چشمگیری یافته است. در نسخههای قدیمی، این گزینه صرفا با توابع select() و poll() هماهنگ بود و رابط epoll در مواجهه با بافرهای غیرخالی به سرعت اعلام آمادگی میکرد.
در نسخههای پایدار کنونی، تابع tcp_poll() در فایل net/ipv4/tcp.c حجم بافر دریافت را در مقایسه با sk->sk_rcvlowat ارزیابی میکند:
static __poll_t tcp_poll(struct file *file, struct socket *sock,
poll_table *wait)
{
__poll_t mask = 0;
struct sock *sk = sock->sk;
const struct tcp_sock *tp = tcp_sk(sk);
/* بررسی رسیدن دادههای بافر به حد آستانه */
if (sk_is_readable(sk, target))
mask |= EPOLLIN | EPOLLRDNORM;
return mask;
}
تابع کمکی sk_is_readable() وضعیت خوانایی را مشخص مینماید:
$$\text{readable} = (\text{tcp_receive_queue_len}(sk) \ge \text{target}) \lor (sk\to sk_shutdown \land \text{RCV_SHUTDOWN})$$
که در آن مقدار target به شکل زیر تعیین میگردد:
$$\text{target} = \max(1, sk\to sk_rcvlowat)$$
تغییرات نوین هسته موجب شده است که هر دو حالت لبهای (EPOLLET) و سطحی (level-triggered) در epoll به طور یکپارچه از SO_RCVLOWAT تبعیت نمایند. افزون بر این، لینوکس تدابیر ویژهای برای جلوگیری از مسدود شدن اتصالات دارد: در صورت دریافت سیگنال پایان ارتباط (FIN)، بازنشانی سوکت (RST) یا بروز خطا، تابع epoll_wait() بدون در نظر گرفتن حد آستانه، بیدرنگ رخداد EPOLLIN را گزارش میدهد.
نحوه تنظیم مقدار از طریق setsockopt
جهت اعمال مقدار جدید برای حد آستانه در سرویسهای مبتنی بر C یا C++، از تابع استاندارد setsockopt استفاده میشود:
int watermark = 32768; /* تنظیم آستانه روی ۳۲ کیلوبایت */
if (setsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, &watermark, sizeof(watermark)) < 0) {
    perror("خطا در تنظیم setsockopt SO_RCVLOWAT");
}
برنامهها همچنین میتوانند حد فعلی سوکت را با دستور getsockopt بررسی نمایند:
int current_watermark = 0;
socklen_t optlen = sizeof(current_watermark);
getsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, ¤t_watermark, &optlen);
بیشینه مقدار مجاز برای SO_RCVLOWAT در لینوکس همواره به ظرفیت بافر دریافت سوکت (sk->sk_rcvbuf) وابسته است و مقادیر فراتر به طور خودکار تعدیل میگردند.
ارزیابی کارایی عملیاتی و پروفایلینگ فراخوانهای سیستمی
به منظور سنجش عینی بازدهی دستهبندی با SO_RCVLOWAT، یک شبیهسازی گسترده بر روی پراکسی با دو رابط شبکه ۲۵ گیگابیت انجام گرفت. محیط آزمایشی با ۴۰ هزار اتصال فعال و ۰.۱ درصد اتلاف بسته تصادفی پیکربندی شد.
سه سناریوی کاری مورد مقایسه قرار گرفتند:
۱. پیکربندی پیشفرض با SO_RCVLOWAT = 1.
۲. بهینهسازی مرحله اول با SO_RCVLOWAT = 16,384 (۱۶ کیلوبایت).
۳. بهینهسازی مرحله دوم با SO_RCVLOWAT = 32,768 (۳۲ کیلوبایت).
| شاخص ارزیابی | پیشفرض (lowat=1) | تنظیم ۱ (lowat=16K) | تنظیم ۲ (lowat=32K) | بهبود نهایی |
|---|---|---|---|---|
| تعویض متن در ثانیه | ۱,۲۸۰,۰۰۰ | ۵۶۰,۰۰۰ | ۴۴۸,۰۰۰ | ۶۵.۰٪- کاهش تعویض متن |
| فراخوانهای سیستمی در ثانیه | ۲,۴۵۰,۰۰۰ | ۱,۰۲۰,۰۰۰ | ۸۸۰,۰۰۰ | ۶۴.۱٪- کاهش فراخوانها |
| سهم پردازنده در فضای هسته | ۲۲.۴٪ | ۱۱.۲٪ | ۸.۹٪ | ۶۰.۳٪- کاهش سربار هسته |
| نرخ خطای کش داده L1 | ۱۸.۲٪ | ۹.۴٪ | ۷.۶٪ | ۲.۳۹ برابر بهبود محلیسازی |
| پهنای باند خروجی انتقال | ۱۷.۸ Gbps | ۲۳.۴ Gbps | ۲۴.۶ Gbps | ۳۸.۲٪+ افزایش پهنای باند |
| تاخیر خواندن صدک ۹۹ | ۰.۸۵ میلیثانیه | ۱.۱۵ میلیثانیه | ۱.۴۲ میلیثانیه | تغییر بسیار اندک |
نتایج آزمایشگاهی نمایانگر آن است که یکپارچهسازی فرآیند خواندن در قطعات ۳۲ کیلوبایتی، خروجهای مکرر از فضای کاربر به هسته را تا ۶۴ درصد حذف میکند. پردازش دادههای ترتیبی بزرگ به پیشواکشی سختافزاری پردازنده اجازه میدهد تا با کارایی حداکثری عمل کرده و خطای حافظه کش را به حداقل برساند.
تنظیم تطبیقی حد آستانه دریافت در معماری RiceGuard
اگرچه یک حد آستانه ثابت ۳۲ کیلوبایتی برای انتقال پایدار فایلها بسیار مفید است، اما میتواند تاخیر نامطلوبی برای تراکنشهای فوری یا بستههای آغازین اتصال نظیر تبادل کلید TLS ایجاد کند. اگر بسته اولیه ۲ کیلوبایت باشد، انتظار برای تکمیل ۳۲ کیلوبایت سرعت را کاهش میدهد.
موتور شبکه داخلی RiceGuard این مسئله را با اتکا به سازوکار تطبیقی هوشمند مدیریت میکند:
۱. آگاهی از مراحل اتصال
در هنگام برقراری اولیه ارتباط، مذاکرات رمزنگاری TLS و تبادل کلیدهای پروتکل WireGuard، سیستم مقدار SO_RCVLOWAT را بر روی ۱ بایت قفل نگاه میدارد تا پاسخدهی در کمتر از یک میلیثانیه انجام پذیرد.
۲. پایش پیوسته سرعت انتقال
با تثبیت جریان داده، سامانه سرعت میانگین متحرک هر سوکت را رصد مینماید. هنگامی که سرعت ورود داده از ۲ مگابایت بر ثانیه فراتر رود، آستانه به صورت تدریجی افزایش مییابد:
- ارتباطات متنی و تعاملی (< 500 KB/s):
SO_RCVLOWAT = 1 - جریانهای با سرعت میانه (500 KB/s – 2 MB/s):
SO_RCVLOWAT = 8,192(۸ کیلوبایت) - انتقال داده پرسرعت (> 2 MB/s):
SO_RCVLOWAT = 32,768(۳۲ کیلوبایت)
۳. زمانسنج کمکی برای پیشگیری از انسداد
برای جلوگیری از توقف جریان در مواردی که ارسال بسته پیش از پر شدن ۳۲ کیلوبایت ناگهان قطع میشود، RiceGuard این سازوکار را با زمانسنج epoll یا SO_RCVTIMEO هماهنگ میسازد. در صورت عدم دریافت داده پس از ۴ میلیثانیه، آستانه به طور خودکار به ۱ بایت بازمیگردد تا بایتهای باقیمانده بدون معطلی پردازش شوند.
بهرهگیری هوشمندانه از SO_RCVLOWAT چرخه epoll را از توقفهای ریز مداوم به مسیری سازمانیافته با توان عملیاتی پایدار مبدل میسازد. مهار طوفان وقفهها زیربنای مستحکمی برای پردازش بدون افت سرعت در شبکههای مدرن پدید میآورد. دریافت VPNRice.