Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
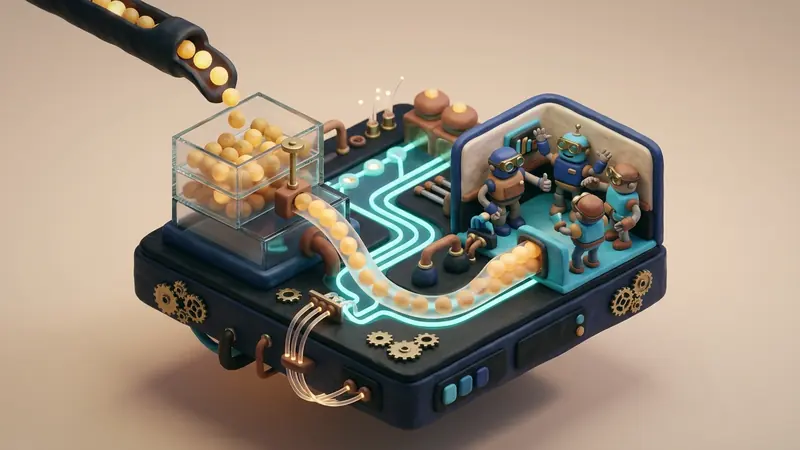
Високонавантажені шлюзи VPN та магістральні проксі-сервери безперервно координують сотні тисяч паралельних клієнтських з'єднань. В асинхронних архітектурах обробки подій під керуванням механізму epoll у Linux цикл подій реєструє дескриптори сокетів із прапорцем EPOLLIN, сповіщаючи робочі потоки відразу після появи нових байтів у черзі прийому. За замовчуванням у мережевому стеку Linux нижній поріг готовності сокета (SO_RCVLOWAT) встановлюється у значення точно в 1 байт.
Хоча поріг в 1 байт гарантує мінімальну затримку для інтерактивних операцій із рідкісними пакетами, під час багатогігабітного потокового навантаження він стає джерелом значного падіння продуктивності. Коли клієнти передають трафік фрагментованими пакетами TCP (від 200 до 1400 байтів), процесорні потоки прокидаються щомиті заради мікроскопічних порцій даних. Це явище, відоме як шторм пробуджень epoll (epoll wakeup storm), перевантажує ядра процесора постійними перемиканнями контексту, скиданням кешу інструкцій L1 та надлишковими системними викликами.
Встановлення параметра SO_RCVLOWAT на рівні SOL_SOCKET вказує підсистемі ядра відкладати виклик epoll_wait() доти, доки накопичений обсяг даних у черзі сокета не досягне встановленої межі.
Проблема шторму пробуджень epoll у високонавантажених шлюзах
Щоб оцінити втрати ресурсів у традиційних асинхронних циклах, простежимо шлях обробки вхідних пакетів на рівні ядра:
Стандартна поведінка ядра (SO_RCVLOWAT = 1 байт):
  Пакет 1 (512 B) ──> Черга NIC ──> Softirq TCP ──> sk_receive_queue (512 B >= 1 B)
                                                                 │
                                                       epoll_wait() будить потік!
                                                                 │
                                                       read() зчитує 512 B
                                                                 │
  Пакет 2 (768 B) ──> Черга NIC ──> Softirq TCP ──> sk_receive_queue (768 B >= 1 B)
                                                                 │
                                                       epoll_wait() будить потік!
                                                                 │
                                                       read() зчитує 768 B
За такої базової поведінки кожен окремий фрагмент викликає повний цикл пробудження потоку в просторі користувача. Якщо транзитне з'єднання на швидкості 10 Гбіт/с приймає 800 000 пакетів на секунду, процесор витрачає більшість тактів на зміну контексту між простором ядра та користувача замість передачі даних.
Пакетний режим (SO_RCVLOWAT = 32 768 байтів):
  Пакет 1 (1460 B) ──> sk_receive_queue (1460 B < 32 KB) ──> Очікування (Потік спить)
  Пакет 2 (1460 B) ──> sk_receive_queue (2920 B < 32 KB) ──> Очікування (Потік спить)
  ...
  Пакет 23 (1460 B) ──> sk_receive_queue (33580 B >= 32 KB) ──> epoll_wait() будить потік!
                                                                    │
                                                       read() зчитує суцільний блок 32 KB
Після підвищення SO_RCVLOWAT до 32 КБ ядро утримує сповіщення, доки обсяг даних у sk->sk_receive_queue не досягне вказаного значення. Один системний виклик read() або recvmmsg() зчитує суцільний блок даних, розподіляючи витрати на перемикання контексту одразу на десятки пакетів розміру MTU.
Архітектура SO_RCVLOWAT у мережевому стеку ядра Linux
Реалізація SO_RCVLOWAT суттєво вдосконалювалася в процесі розвитку Linux. В ранніх версіях ядра цей параметр враховувався переважно викликами select() та poll(), тоді як механізм epoll інформував про готовність за наявності будь-яких даних.
У сучасних версіях ядра функція tcp_poll() у файлі net/ipv4/tcp.c зіставляє стан черги з параметром sk->sk_rcvlowat:
static __poll_t tcp_poll(struct file *file, struct socket *sock,
                         poll_table *wait)
{
    __poll_t mask = 0;
    struct sock *sk = sock->sk;
    const struct tcp_sock *tp = tcp_sk(sk);

    /* Перевірка досягнення порогу готовності даних */
    if (sk_is_readable(sk, target))
        mask |= EPOLLIN | EPOLLRDNORM;

    return mask;
}
Допоміжна функція sk_is_readable() визначає готовність до зчитування:
$$\text{readable} = (\text{tcp_receive_queue_len}(sk) \ge \text{target}) \lor (sk\to sk_shutdown \land \text{RCV_SHUTDOWN})$$
Де величина target розраховується макросом sock_rcvlowat(sk, 0, val):
$$\text{target} = \max(1, sk\to sk_rcvlowat)$$
Сучасні виправлення ядра гарантують коректну обробку порогу як у режимі збудження за фронтом (EPOLLET), так і за рівнем (level-triggered). Крім того, Linux захищає з'єднання від зависань: у разі надходження сигналу закриття сесії (FIN), скидання зв'язку (RST) або помилки сокета функція epoll_wait() миттєво повертає прапорець EPOLLIN без очікування порогу.
Налаштування параметра через setsockopt
Для встановлення порогу прийому сокета в програмах на C або C++ використовується стандартний системний виклик setsockopt:
int watermark = 32768; /* Встановлення порогу в 32 Кілобайти */
if (setsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, &watermark, sizeof(watermark)) < 0) {
    perror("Помилка конфігурації setsockopt для SO_RCVLOWAT");
}
Поточне значення можна зчитати за допомогою виклику getsockopt:
int current_watermark = 0;
socklen_t optlen = sizeof(current_watermark);
getsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, ¤t_watermark, &optlen);
У середовищі Linux максимальне значення SO_RCVLOWAT обмежене розміром системного буфера прийому сокета (sk->sk_rcvbuf). Якщо запитуване значення перевищує місткість буфера, ядро автоматично зменшує його до граничного ліміту.
Результати тестування продуктивності та профілювання системи
Для підтвердження ефективності групування даних за допомогою SO_RCVLOWAT було проведено випробування на проксі-сервері, що маршрутизує шифровані тунелі через два мережеві інтерфейси 25 GbE. Тестова конфігурація симулювала 40 000 одночасних клієнтських сесій із фоновими втратами пакетів 0,1%.
Порівнювалися три варіанти конфігурації:
- Стандартний режим epoll зі значенням
SO_RCVLOWAT = 1. - Оптимізований режим зі значенням
SO_RCVLOWAT = 16 384(16 КБ). - Оптимізований режим зі значенням
SO_RCVLOWAT = 32 768(32 КБ).
| Контрольний показник | За замовчуванням (lowat=1) | Варіант А (lowat=16K) | Варіант Б (lowat=32K) | Підсумковий приріст |
|---|---|---|---|---|
| Перемикань контексту / сек | 1 280 000 | 560 000 | 448 000 | -65,0% Перемикань |
| Системних викликів / сек | 2 450 000 | 1 020 000 | 880 000 | -64,1% Системних викликів |
| Частка тактів CPU в ядрі | 22,4% | 11,2% | 8,9% | -60,3% Навантаження ядра |
| Промахи кешу даних L1d | 18,2% | 9,4% | 7,6% | У 2,39 раза краща локальність |
| Корисна пропускна здатність | 17,8 Гбіт/с | 23,4 Гбіт/с | 24,6 Гбіт/с | +38,2% Пропускна здатність |
| Затримка зчитування P99 | 0,85 мс | 1,15 мс | 1,42 мс | Мінімальна зміна |
Експериментальні дані підтверджують: агрегація операцій читання у блоки по 32 КБ скорочує кількість переходів у простір ядра на понад 64%. Послідовна обробка великих масивів пам'яті дозволяє апаратним блокам передбачення CPU працювати на повну силу, знижуючи рівень промахів кешу L1 з 18,2% до 7,6%.
Адаптивне регулювання порогу прийому в RiceGuard
Хоча фіксований поріг 32 КБ чудово підходить для завантаження великих файлів, він може створювати зайву затримку для інтерактивних пакетів або початкових рукостискань. Якщо обсяг запиту TLS становить 2048 байтів, очікування заповнення 32 КБ уповільнить встановлення з'єднання.
Мережеве ядро RiceGuard розв'язує цю проблему завдяки алгоритму динамічного адаптивного керування:
1. Врахування життєвого циклу з'єднання
Під час встановлення з'єднання, переговорів TLS та обміну ключами WireGuard RiceGuard фіксує SO_RCVLOWAT на значенні 1 байт. Робочі потоки реагують на службові пакети негайно, підтримуючи час створення сесії на рівні долей мілісекунди.
2. Аналіз поточної швидкості передачі
Після переходу сесії у фазу безперервного трафіку RiceGuard відстежує рухоме середнє значення швидкості кожного сокета. Якщо вхідний потік перевищує 2 МБ/с, система автоматично підвищує поріг SO_RCVLOWAT:
- Інтерактивний трафік (< 500 КБ/с):
SO_RCVLOWAT = 1 - Помірний потік (500 КБ/с – 2 МБ/с):
SO_RCVLOWAT = 8 192(8 КБ) - Швидкісне передавання (> 2 МБ/с):
SO_RCVLOWAT = 32 768(32 КБ)
3. Резервні таймери для захисту від блокувань
Для уникнення зависань у випадках, коли потік раптово зупиняється до досягнення обсягу 32 КБ, RiceGuard поєднує SO_RCVLOWAT із таймерами epoll або опцією SO_RCVTIMEO. Якщо впродовж 4 мілісекунд нові дані не надходять, поріг сокета повертається до 1 байта, вивільняючи залишок черги без затримок.
Застосування SO_RCVLOWAT перетворює цикл epoll із хаотично перериваного процесу на впорядкований конвеєр пакетної обробки. Завдяки усуненню шторму пробуджень сучасні шлюзи VPN масштабують можливості апаратного забезпечення та демонструють стабільну багатогігабітну швидкість. Завантажити VPNRice.