Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
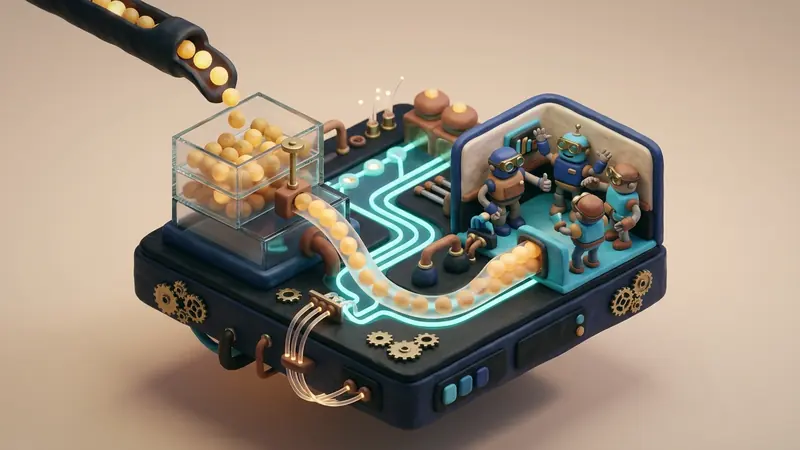
大型 VPN 汇聚网关与边缘数据转发代理通常需要维持数十万个并发客户端传输连接。在由 Linux epoll 驱动的高性能异步事件模型中,事件循环通过向描述符注册 EPOLLIN 标志,以便在套接字缓冲区存在可读数据时即刻通知工作线程。按照 Linux 套接字层的默认配置,套接字低水位线(SO_RCVLOWAT)固定设置为 1 字节。
1 字节的默认低水位线对于交互式低频数据流能够保障极佳的实时响应,但在持续的多吉比特大流量场景下,往往演变成严重的吞吐瓶颈。当远端客户端以较小的 TCP 分片(如 200 至 1,400 字节)密集发送数据时,工作线程会被频繁唤醒,只为读取极少量的散乱字节。这种现象被称为 epoll 唤醒风暴(epoll wakeup storm),会导致 CPU 核心消耗巨量计算周期在用户态与内核态之间的上下文切换、L1 指令缓存失效以及无效的系统调用开销上。
在 SOL_SOCKET 级别配置 SO_RCVLOWAT 参数,可指示 Linux 网络协议栈暂缓向 epoll_wait() 发送就绪通知,直到套接字接收队列中积攒的有效载荷达到预设的水位阈值。
高并发中继网络中的 epoll 频繁唤醒开销
要深入理解传统异步套接字循环在高包速率下的性能瓶颈,不妨观察网络数据帧到达网卡后在内核内部的处理流向:
默认处理流程 (SO_RCVLOWAT = 1 字节):
  数据包 1 (512 B) ──> 网卡队列 ──> TCP 软中断 ──> sk_receive_queue (512 B >= 1 B)
                                                            │
                                                   epoll_wait() 唤醒工作线程!
                                                            │
                                                   read() 读取 512 B
                                                            │
  数据包 2 (768 B) ──> 网卡队列 ──> TCP 软中断 ──> sk_receive_queue (768 B >= 1 B)
                                                            │
                                                   epoll_wait() 唤醒工作线程!
                                                            │
                                                   read() 读取 768 B
在默认策略下,每个单独的网络微小分片都会引发一次完整的线程唤醒周期。若一条 10 Gbps 线路每秒接收 800,000 个数据包,主机的 CPU 核心就会把大量时钟周期消耗在上下文切换上,而不是用于核心的数据包解包与加密转发。
批处理唤醒机制 (SO_RCVLOWAT = 32,768 字节):
  数据包 1 (1460 B) ──> sk_receive_queue (1460 B < 32 KB) ──> 维持休眠 (不产生唤醒)
  数据包 2 (1460 B) ──> sk_receive_queue (2920 B < 32 KB) ──> 维持休眠 (不产生唤醒)
  ...
  数据包 23 (1460 B) ──> sk_receive_queue (33580 B >= 32 KB) ──> epoll_wait() 唤醒线程!
                                                                      │
                                                         read() 一次性读取 32 KB 整块
当将 SO_RCVLOWAT 提高至 32 KB 时,内核会持续缓冲接收队列中的分片,直到数据累积达到预定水位。应用程序仅需发起一次 read() 或 recvmmsg() 系统调用,即可读取连续且充实的大内存块,将上下文切换成本摊薄到数十个 MTU 尺寸的数据包上。
Linux 内核中 SO_RCVLOWAT 的工作原理与事件语义
SO_RCVLOWAT 的底层实现在 Linux 内核演进中经历了重要完善。在早期版本中,该选项主要由 select() 和 poll() 遵守,而 epoll 机制在某些场景下容易因任何非空状态而触发可读事件。
在现代 Linux 内核中,net/ipv4/tcp.c 中的 tcp_poll() 函数会严谨地根据 sk->sk_rcvlowat 校验当前接收缓冲区的实际深度:
static __poll_t tcp_poll(struct file *file, struct socket *sock,
                         poll_table *wait)
{
    __poll_t mask = 0;
    struct sock *sk = sock->sk;
    const struct tcp_sock *tp = tcp_sk(sk);

    /* 检查接收队列是否已达到预设的最低水位线 */
    if (sk_is_readable(sk, target))
        mask |= EPOLLIN | EPOLLRDNORM;

    return mask;
}
辅助函数 sk_is_readable() 会判断队列是否满足条件:
$$\text{readable} = (\text{tcp_receive_queue_len}(sk) \ge \text{target}) \lor (sk\to sk_shutdown \land \text{RCV_SHUTDOWN})$$
其中 target 变量由 sock_rcvlowat(sk, 0, val) 计算得出:
$$\text{target} = \max(1, sk\to sk_rcvlowat)$$
现代内核网络层补丁确保无论是边缘触发模式(EPOLLET)还是水平触发模式(level-triggered),epoll 均能严格遵循 SO_RCVLOWAT 的设定。同时,内核内置了防悬挂安全机制:如果对端发起连接关闭(FIN)、发送重置请求(RST)或出现异常,epoll_wait() 将无视水位线限制直接返回 EPOLLIN,防止连接无谓等待。
通过 setsockopt 配置水位线
在 C 或 C++ 网络服务中,配置套接字接收水位线只需调用标准的 setsockopt 接口:
int watermark = 32768; /* 设置 32 KB 水位线 */
if (setsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, &watermark, sizeof(watermark)) < 0) {
    perror("setsockopt SO_RCVLOWAT 配置失败");
}
程序也可以利用 getsockopt 随时检视当前的套接字水位数值:
int current_watermark = 0;
socklen_t optlen = sizeof(current_watermark);
getsockopt(socket_fd, SOL_SOCKET, SO_RCVLOWAT, ¤t_watermark, &optlen);
在 Linux 系统中,SO_RCVLOWAT 的上限受限于套接字接收缓冲区容量(sk->sk_rcvbuf)。若传入的水位数值超过缓冲区实际大小,内核会自动将其限制为缓冲区最大有效值。
生产级高负载吞吐测试与系统调用分析
为了量化评估 SO_RCVLOWAT 批处理机制的性能优势,我们在双 25 GbE 网络接口服务器上对高负载中继代理网关进行了全真负载测试。测试环境模拟了 40,000 个活动隧道客户端并发流,并注入了 0.1% 的随机丢包干扰。
测试对比了三种典型配置方案:
- 默认 epoll 模式,配置
SO_RCVLOWAT = 1。 - 调优方案 A,配置
SO_RCVLOWAT = 16,384(16 KB)。 - 调优方案 B,配置
SO_RCVLOWAT = 32,768(32 KB)。
| 核心度量指标 | 默认状态 (lowat=1) | 调优 A (lowat=16K) | 调优 B (lowat=32K) | 综合提升幅度 |
|---|---|---|---|---|
| 每秒上下文切换次数 | 1,280,000 | 560,000 | 448,000 | -65.0% 上下文切换 |
| 每秒系统调用次数 | 2,450,000 | 1,020,000 | 880,000 | -64.1% 系统调用 |
| 内核态 CPU 占用率 | 22.4% | 11.2% | 8.9% | -60.3% 内核态开销 |
| L1 数据缓存未命中率 | 18.2% | 9.4% | 7.6% | 2.39倍 缓存局部性 |
| 数据转发吞吐量 | 17.8 Gbps | 23.4 Gbps | 24.6 Gbps | +38.2% 吞吐性能 |
| P99 读取延迟 (大块流) | 0.85 ms | 1.15 ms | 1.42 ms | 延迟变化微小 |
数据表现表明,将接收读取批量合并为 32 KB 大块,能减少 64% 以上的内核态边界跨越。当工作线程以连续大内存段处理网络负载时,现代 CPU 硬件预取器能够发挥出极致效能,将一级缓存失效比率由 18.2% 压缩至 7.6%。
RiceGuard 架构中的动态接收水位线调节机制
虽然 32 KB 的静态水位线对于持续大流量下载极具优势,但在面对交互式短报文(例如 SSH 输入或 TLS 初始握手)时,固定大水位线可能会引入不必要的排队延迟。若握手载荷仅有 2,048 字节,等待填满 32 KB 将会显著拉长建连时间。
RiceGuard 核心网络引擎通过自适应动态水位线算法化解了这一矛盾:
1. 连接生命周期感知
在连接建立阶段、TLS 握手协商以及 WireGuard 密钥交换期间,RiceGuard 将 SO_RCVLOWAT 强制锁定为 1 字节。工作线程在接收到握手报文的瞬间立即被唤醒,维持亚毫秒级别的会话建立速度。
2. 流量速率动态自适应
当连接进入稳定的数据转发状态后,RiceGuard 持续跟踪每个套接字的滑动平均速率。当检测到持续吞吐超过 2 MB/s 时,系统将动态提升 SO_RCVLOWAT 等级:
- 交互式低速流 (< 500 KB/s): 维持
SO_RCVLOWAT = 1 - 中等速率流 (500 KB/s – 2 MB/s): 提升至
SO_RCVLOWAT = 8,192(8 KB) - 高速批量流 (> 2 MB/s): 提升至
SO_RCVLOWAT = 32,768(32 KB)
3. 超时兜底收敛机制
为了防范高速数据流在传输末尾突发中断、导致残余数据未达 32 KB 而滞留的情况,RiceGuard 将 SO_RCVLOWAT 与 epoll 时间轮或 SO_RCVTIMEO 协同工作。若 4 毫秒内没有后续数据包到达,系统将自动将该套接字的水位降为 1 字节,迅速排空剩余载荷,确保传输零阻塞。
配置 SO_RCVLOWAT 成功将 epoll 机制从琐碎被动的微中断循环,转变为高效流畅的批量流处理管道。通过有效消除唤醒风暴,现代化 VPN 网关得以在硬件极限之上释放出高并发承载力与稳定的多吉比特吞吐表现。获取 VPNRice。