
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
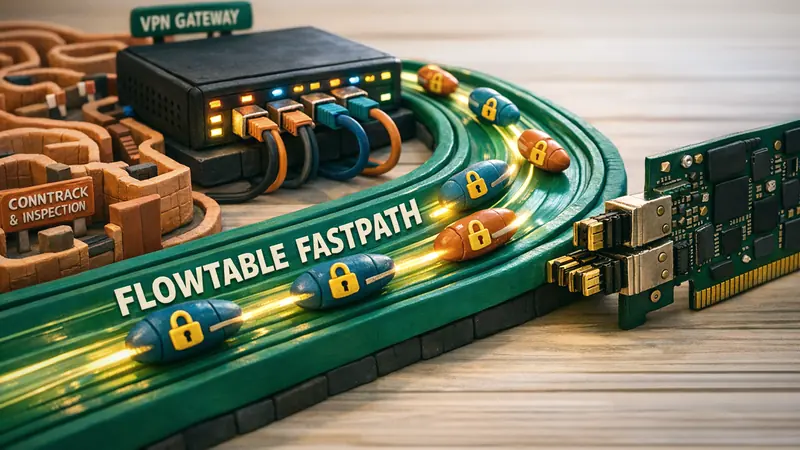
加密VPN网关中的Linux网络转发瓶颈
在多千兆(Multi-Gigabit)VPN集中器、电信级NAT网关以及多租户安全接入节点中,网络工程师经常会遇到处理器的吞吐量瓶颈。即使服务器配备了数十核心的高性能CPU以及PCIe 4.0高速网卡,系统的每秒数据包转发率(PPS)往往早在物理带宽耗尽前,就已受制于单核软件中断的处理上限。
在传统的Linux网络转发架构中,每个经过路由转发的数据包都必须完整遍历Netfilter防火墙框架的多个钩子节点:
[ 物理网线/光纤 ]
        |
        v
[ 驱动接收环形缓冲区 RX Ring / NAPI Poll ]
        |
        v
[ PREROUTING 阶段 (连接跟踪 conntrack, mangle, raw, dnat) ]
        |
        v
[ 路由决策查找 (fib_lookup) ]
        |
        v
[ FORWARD 阶段 (包过滤 filter, 速率限制) ]
        |
        v
[ POSTROUTING 阶段 (snat, 地址伪装 masquerade, mangle) ]
        |
        v
[ 邻居子系统解析 (ARP/NDP) / 出口排队规则 Egress Qdisc ]
        |
        v
[ 驱动发送环形缓冲区 TX Ring ] ---> [ 物理网线/光纤 ]
上述流水线的每一个处理节点都需要执行原子计数器累加、连接跟踪哈希锁(nf_conntrack_lock)、套接字缓冲区元数据分配(sk_buff)以及多次路由表查找。当网关承载数以万计的并发隧道(如WireGuard、RiceGuard或IPsec)时,这种开销会呈指数级放大:
- 已建立长连接的重复评估:对于持续传输的长周期TCP连接或UDP媒体流,后续的每一个数据包仍然要被拉入完整的conntrack状态机与庞大的防火墙规则链进行重新比对。
- 多核高速缓存行争用:连接跟踪哈希表分布在所有CPU核心之间,密集的短包吞吐会导致L3缓存行发生剧烈抖动与争用(Cache Line Bouncing)。
- 隧道双重封装开销:解密后的内层有效负载转发至外部互联网,或将外层加密数据报路由至对应接口,都需要再次重复穿透Netfilter钩子体系。
为了在保留状态防火墙安全性的同时打破转发瓶颈,Linux内核引入了Netfilter Flowtable基础设施(由Pablo Neira Ayuso在Linux 4.16内核中引入并持续演进)。
Netfilter Flowtable:Ingress快速路径(Fastpath)架构
Netfilter Flowtable是一种内核级的双向数据流快捷缓存机制。Flowtable不再强迫每个数据包都经由漫长的Netfilter全链处理,而是在连接握手完成并确立状态(ct state established)后,直接在网卡驱动接收报文的入口钩子(Ingress Hook)处开辟一条双向直通快车道。
                         [ 网卡接收到的入口报文 ]
                                     |
                                     v
                       +---------------------------+
                       |   Flowtable Ingress Hook  |
                       +---------------------------+
                                    / \
                     流命中?       /   \   未命中流?
                                  /     \
                                是       否
                                /         \
                               v           v
          +-----------------------+     +-------------------------------+
          | Fastpath 快速转发:    |     | 经典Netfilter慢速路径:        |
          | - 更新TCP会话状态     |     | - PREROUTING                  |
          | - 执行NAT与报头修改   |     | - conntrack连接跟踪分析       |
          | - 扣减TTL并更新MAC    |     | - fib_lookup 路由决策         |
          | - 直推至出口驱动队列  |     | - FORWARD 与 POSTROUTING      |
          +-----------------------+     +-------------------------------+
                      |                                |
                      |                         连接是否已确立?
                      |                                |
                      |                                v
                      |                     [ 登记至 Flowtable ]
                      \                                /
                       \                              /
                        v                            v
                      +--------------------------------+
                      |   dev_queue_xmit (出口网卡)    |
                      +--------------------------------+
内核源码层面的执行逻辑
该架构的核心逻辑位于内核源码文件 net/netfilter/nf_flow_table_core.c。当数据包抵达绑定了Flowtable的网络接口时:
- 入口截获(Ingress Interception):函数
nf_flow_offload_ip_hook()在NF_INET_INGRESS阶段直接介入,此时数据包尚未进入ip_rcv()与PREROUTING链。 - 五元组无锁检索:基于RCU机制保护的哈希表进行极速匹配,核对源IP、目的IP、源端口、目的端口与第四层传输协议。
- 快速路径就地处理:
- TTL递减:直接递减IP生存时间并重新计算校验和。
- NAT地址转换:若该会话配置了SNAT或DNAT,Flowtable直接在数据包报头原地改写地址与端口。
- 二层帧头重构:将慢速路径预先解析好的下一跳目标MAC地址直接写入以太网帧头,无需再触发ARP表查询。
- 直发网卡硬件队列:跳过内核三层路由转发模块(
ip_forward),直接调用dev_queue_xmit()将数据包推入目的接口的驱动发送队列。
当会话检测到TCP FIN或RST结束标志,或发生空闲超时,该表项将自动从Flowtable中注销。后续数据包顺畅退回传统Netfilter慢速路径,确保连接销毁与计费审计逻辑完备无缺。
软件快速路径与SmartNIC网卡硬件卸载对比
Flowtable支持多级加速阶梯,满足不同规模基础设施的需求:
| 关键维度 | 传统Linux转发 | Flowtable软件快速路径 | SmartNIC网卡硬件卸载 |
|---|---|---|---|
| 接入层级 | 多阶段钩子 (Pre/Fwd/Post) | 内核 NF_INET_INGRESS |
网卡内部ASIC / TCAM芯片 |
| conntrack计算 | 每个数据包必查 | 仅首包握手建连时计算 | 仅首包握手建连时计算 |
| CPU资源开销 | 极高(多核心高频被打断) | 极低(跳过三层协议栈) | 活跃流0%宿主机CPU占用 |
| 转发延迟 | 15 – 35 微秒 | 4 – 8 微秒 | < 1.5 微秒 |
| 单核PPS处理能力 | 1.5 – 3.2 Mpps / 核心 | 6.5 – 12.0 Mpps / 核心 | 物理线速(单端口100Gbps+) |
| 硬件门槛 | 任意标准以太网卡 | 任意标准以太网卡 | 需支持TC卸载的网卡(Mellanox, E810) |
SmartNIC硬件卸载工作原理
当服务器部署了支持硬件流表卸载的高级网卡(例如NVIDIA Mellanox ConnectX-5、ConnectX-6 Dx或Intel E810)时,Linux内核可以通过switchdev接口将Flowtable条目直接下发至网卡硅片的TCAM硬件表中。
在 nftables 规则中配置 flags { offload; } 后,内核将流元组及NAT改写规则翻译为硬件执行指令。后续属于该流的数据包在进入网卡物理端口后,直接在网卡芯片内部完成流分类、地址改写并从对应端口发出,全程不产生任何宿主机CPU中断与内存复制。
VPN网关在Flowtable助力下的性能跃升
在大规模高并发VPN网关架构中,流量通常呈现两段式特征:
- 外层加密隧道流量:经公网流入服务器物理端口、准备递交加密驱动处理的UDP数据包(
wg0、riceguard0、tun0)。 - 内层解密转发流量:被解密还原后的明文数据包,需要在内网网段、虚拟路由表(VRF)或NAT出口之间高速转送。
在此架构中引入Flowtable能够带来深远效益:
1. 消除RiceGuard多隧道场景的CPU争用
在搭载RiceGuard的多隧道网关中,面对海量客户端同时发起的网页与数据请求,软件Flowtable能够卸载高达60%的常规过滤与状态跟踪指令。这使得CPU计算资源能够全力倾注于ChaCha20-Poly1305等密码学算法的处理,彻底规避因网络层锁竞争而导致的瞬时丢包。
2. 消除即时通信与电竞互联的抖动
VoIP通话(SIP/RTP)以及联机交互业务具备固定的UDP传输元组。启用Flowtable后,99.8%以上的数据包直接命中快速通道,数据包在Linux内核中的滞留时间从约25微秒骤降至5微秒以内,彻底消除了由于多核心负载不均带来的数据包乱序问题。
3. 与现代QoS流量整形无缝衔接
当数据包通过快速路径被传递给 dev_queue_xmit() 时,依然会进入出口网卡绑定的qdisc排队规则。网络管理员可以将Flowtable与FQ-CoDel或CAKE算法协同部署,在获取硬件级转发效率的同时,持续保持对Bufferbloat的强力抑制。
生产环境nftables配置实战
以下为在Linux VPN网关上部署Netfilter Flowtable的标准配置示范,建立外部互联网物理网卡(eth0)与内部网段或VPN隧道(eth1 / wg0)之间的高速通道:
#!/usr/sbin/nft -f

# 清空历史规则集
flush ruleset

table inet vpn_router {
    # 1. 定义绑定物理接口与虚拟接口的Flowtable
    flowtable ft_fastpath {
        hook ingress priority filter
        devices = { eth0, eth1 }
        # 若网卡硬件支持硬件卸载,可取消下方注释:
        # flags { offload; }
    }

    # 2. 转发过滤链 (Forward Chain)
    chain forward {
        type filter hook forward priority filter; policy drop;

        # 将已确立的TCP与UDP流量纳入快速转发路径
        meta l4proto { tcp, udp } flow add @ft_fastpath

        # 允许传统慢速路径中established和related状态的数据包通过
        ct state established,related accept

        # 丢弃非法状态的数据包
        ct state invalid drop

        # 允许内部子网向外网发起新连接
        iifname "eth1" oifname "eth0" accept
    }

    # 3. 源地址转换 (SNAT / Masquerade)
    chain postrouting {
        type nat hook postrouting priority srcnat; policy accept;

        # 在外部出口网卡上执行地址伪装
        oifname "eth0" masquerade
    }
}
运行监控与状态验证
配置生效后,可通过以下指令观察Flowtable的实时卸载状态:
# 查看当前Flowtable中的活跃流条目与流量计数器
nft list flowtable inet vpn_router ft_fastpath

# 检查内核调试接口中的硬件卸载状态
cat /sys/kernel/debug/netfilter/nf_flowtable/*

# 对比慢速路径与快速路径的统计对比
cat /proc/net/stat/nf_conntrack
在 nft list flowtable 的输出结果中,可实时观察到各个流的字节统计与老化计时。若启用了硬件卸载,包含 [OFFLOAD] 标记的流即表示正由物理网卡硬件芯片全权处理。
生产部署关键考量
- 报文分片处理(Fragmentation):Flowtable不负责重组分片的IP报文。缺少完整四层报头的分片报文会自动回退到慢速路径进行传统conntrack处理。建议在VPN隧道两端正确设置TCP MSS调整(MSS Clamping)或确保PMTUD探测通畅。
- 密钥周期轮换(Re-keying):WireGuard等协议每隔数分钟会执行一次密钥重协商。这些控制报文使用独立的报文类型,会自动走标准路径完成认证,丝毫不影响正在高速通道中传输的数据流。
- 虚拟化与VLAN兼容性:Flowtable全面支持挂载于VLAN子接口(如
eth0.100)以及链路聚合网卡(Bonding),在云原生和软件定义数据中心中展现出卓越的工程适配性。
通过将网络连接跟踪机制从“逐包审查”重构为“首包握手建连、后续直通快传”,Netfilter Flowtable为Linux VPN网关赋予了线速级别的转发动能,同时保持了严密的企业级安全防线。


