
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
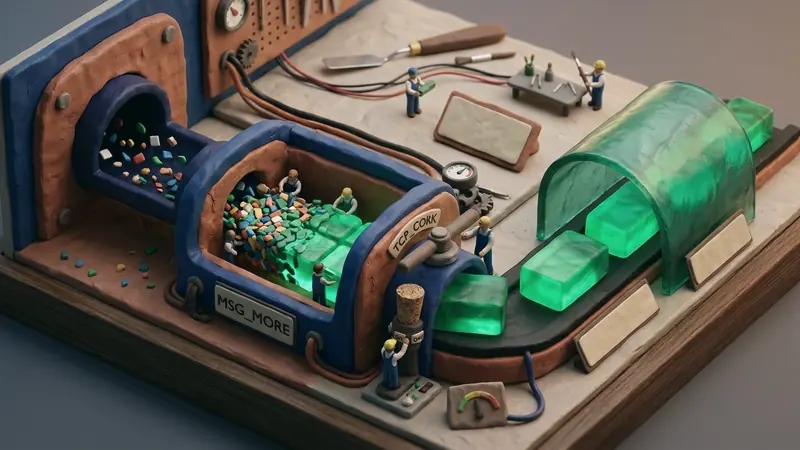
گیتویهای پرسرعت VPN و پراکسیهای شبکه در هر ثانیه میلیونها فریم داده رمزنگاریشده را پردازش میکنند. اگرچه کارتهای شبکه مدرن از پهنای باند چند گیگابیتی پشتیبانی میکنند، برنامههای پراکسی در سطح کاربر اغلب با سقف توان عملیاتی نامرئی ناشی از بار بالای وقفههای نرمافزاری پردازنده (softirq) و اشباع نرخ بسته در ثانیه (PPS) مواجه میشوند. ریشه معماری اصلی این اختلال، تکهتکه شدن بستهها به دلیل جداسازی هدرها است: نوشتن هدرهای پروتکل درست قبل از بار مفید داده، که پشته شبکه را وادار به ارسال بستههای بسیار ریز (tinygrams) میکند.
برای حذف این هزینههای سربار متوالی بدون تحمیل تأخیرهای ناشی از الگوریتمهای سنتی کنترل تراکم، هسته لینوکس دو ابزار در سطح سوکت ارائه میدهد: گزینه TCP_CORK و پرچم ارسال MSG_MORE. درک چگونگی مدیریت صفهای ارسال توسط این سازوکارها به مهندسان شبکه اجازه میدهد توان عملیاتی را افزایش داده، کش پردازنده را بهینهسازی کنند و تأخیر انتقال را در محدوده میکروثانیه حفظ نمایند.
بحران بستههای ریز: سربار قالببندی و طوفان بستهها در VPN
در معماریهای پراکسی فضای کاربر—مانند WireGuard-over-TCP، شدوساکس یا تونلهای کپسولهشده در TLS—مسیر انتقال داده غالباً هدرهای فریم را از محتوای اصلی جدا میسازد. برنامه ابتدا یک هدر کوچک (مثلاً ۱۶ بایت شامل طول داده و مقدار تصادفی رمزنگاری nonce) و بلافاصله پس از آن، داده اصلی (مثلاً یک بسته IP با اندازه ۱۴۲۰ بایت از رابط TUN) را ارسال میکند.
عملیات نوشتن سوکت توسط برنامه:
write(fd, &header, 16); ──> [TCP/IP 54B] + [16B Header] = 70B روی کابل
write(fd, &payload, 1420); ──> [TCP/IP 54B] + [1420B Payload] = 1474B روی کابل
هزینههای سربار ایجاد شده:
- تولید ۲ بسته شبکه جداگانه
- مصرف ۱۰۸ بایت هدر پروتکل
- اشغال ۲ توصیفگر در حلقه دریافت کارت شبکه (Ring Descriptors)
- ایجاد ۲ وقفه سختافزاری در پردازنده گیرنده
هنگامی که گزینه TCP_NODELAY برای حذف تأخیرهای الگوریتم Nagle فعال است، هر فراخوانی سیستمی write() بلافاصله یک سگمنت TCP مجزا تولید کرده و به درایور شبکه تحویل میدهد. ارسال هدر ۱۶ بایتی موجب الصاق ۵۴ بایت هدر TCP/IP (۲۰ بایت IPv4 + ۲۰ بایت TCP + ۱۴ بایت اترنت) شده و یک بسته ۷۰ بایتی ریز تولید میکند. این وضعیت عواقب نامطلوبی به همراه دارد:
- هدررفت پهنای باند: ارسال جداگانه هدرها بین ۴ تا ۱۵ درصد از پهنای باند خام شبکه را صرف هدرهای تکراری پروتکل میکند.
- اشباع نرخ ارسال بسته (PPS): دو برابر شدن تعداد بستهها به ازای هر تبادل منطقی، فشار پردازشی روترها، سوئیچها و جدول رهگیری اتصالات فایروال (conntrack) را به شدت افزایش میدهد.
- فرسودگی پردازنده با وقفه softirq: کارت شبکه مقصد ناچار است مکرراً وقفههای سختافزاری ایجاد کند، حلقههای NAPI را فراخوانی نماید و حافظه sk_buff جداگانه برای دو بسته تخصیص دهد.
چگونگی دگرگونی موتور ارسال TCP لینوکس توسط گزینه TCP_CORK
گزینه سوکت TCP_CORK به پشته شبکه لینوکس دستور میدهد تا تمامی دادههای خروجی را تا رسیدن به سقف حداکثر اندازه سگمنت (MSS) در بافر نگه دارد و سپس ارسال کند، درست مانند مسدود کردن لوله با یک چوبپنبه.
در هسته لینوکس (net/ipv4/tcp_output.c)، تصمیمگیری برای انتقال دادههای بافر به فریم sk_buff توسط توابع tcp_push() و tcp_write_xmit() اداره میشود. هنگامی که TCP_CORK با فراخوانی setsockopt() فعال میگردد، هسته پرچم داخلی tp->nonagle & TCP_NAGLE_CORK را تنظیم میکند.
برخلاف الگوریتم Nagle (RFC 896) که تنها در صورت وجود بستههای تأیید نشده در مسیر، بستهها را متوقف میکند، TCP_CORK کاملاً قطعی و بدون قید عمل مینماید. حتی اگر تمامی دادههای قبلی تایید شده باشند، هسته از ارسال هر بستهای با اندازه کمتر از MSS خودداری میکند، مگر آنکه یکی از دو شرط زیر رخ دهد:
- برداشتن دستی چوبپنبه (Uncorking): برنامه گزینه
TCP_CORKرا باsetsockopt()غیرفعال میکند و باعث تخلیه فوری دادههای بافر به شبکه میشود. - تایمر ایمنی هسته: برای جلوگیری از مسدود ماندن دائمی ناشی از توقف برنامه، هسته یک تایمر ۲۰۰ میلیثانیهای نگهداری میکند. اگر دادهها پس از ۲۰۰ میلیثانیه تخلیه نشوند، هسته بسته را خودکار ارسال مینماید.
بافر ارسال سوکت در صورت فعال بودن TCP_CORK:
┌─────────────────────────────────────────────────────────────┐
│ [16B Header] + [1420B Payload] │
└─────────────────────────────────────────────────────────────┘
│
ارزیابی MTU/MSS توسط هسته
▼
[ارسال یک سگمنت کامل ۱۴۹۰ بایتی در شبکه]
(۱ توصیفگر کارت شبکه، ۱ بسته فیزیکی)
با نگهداشتن هدر در بافر سوکت تا زمان رسیدن دادههای بعدی، TCP_CORK دو مرحله نوشتن را در یک فریم پیوسته ادغام میکند و تولید بستههای ریز را ریشهکن میسازد.
گزینه MSG_MORE: تجمیع دقیق بدون فراخوانی سیستمی در سوکتهای مدرن
با وجود کارایی TCP_CORK، تغییر وضعیت مداوم آن از طریق setsockopt() موجب افزایش هزینههای سوئیچ زمینه (context switch) میگردد. روشن کردن چوبپنبه قبل از هدر و خاموش کردن آن بعد از بار داده، دو فراخوانی سیستمی اضافه به ازای هر پیام ایجاد میکند.
برای رفع این چالش، هسته لینوکس از پرچم MSG_MORE در فراخوانیهای send() و sendto() پشتیبانی میکند.
پرچم MSG_MORE به عنوان یک چوبپنبه موقت عمل مینماید. هنگامی که برنامه پرچم MSG_MORE را ارسال میکند، هسته وضعیت TCP_NAGLE_CORK را فقط برای همان فراخوانی اعمال کرده و دادههای بعدی را منتظر میماند.
// مرحله ۱: ارسال هدر ۱۶ بایتی به همراه پرچم MSG_MORE (نگهداری در بافر)
send(sock_fd, header_buf, 16, MSG_MORE);
// مرحله ۲: ارسال داده اصلی بدون MSG_MORE (تخلیه خودکار و آنی فریم)
send(sock_fd, payload_buf, 1420, 0);
در فراخوانی اول، ۱۶ بایت هدر به بافر فعلی sk_buff اضافه شده و متوقف میماند. در فراخوانی دوم، ۱۴۲۰ بایت به همان ساختار ملحق میگردد. از آنجا که فراخوانی دوم فاقد MSG_MORE است، تابع tcp_push() فریم کامل ۱۴۳۶ بایتی را فوراً تحویل درایور شبکه میدهد. این کار تجمیع بدون نیاز به setsockopt() را به ارمغان میآورد.
همافزایی و تداخل: هماهنگی میان TCP_NODELAY، TCP_CORK و تنظیم آهنگ BBR
مهندسان شبکه غالباً رابطه و اولویت بین TCP_NODELAY و TCP_CORK را بر روی یک سوکت بررسی میکنند. در لینوکس، این تنظیمات با ترتیبی شفاف هماهنگ شدهاند:
سلسلهمراتب اولویت در هسته لینوکس (net/ipv4/tcp_output.c):
┌──────────────────────────────────────────────┐
│ TCP_CORK / MSG_MORE │ <-- بالاترین اولویت
│ (اجبار به تجمیع دادهها تا اندازه MSS) │
└──────────────────────┬───────────────────────┘
│
▼
┌──────────────────────────────────────────────┐
│ TCP_NODELAY │ <-- اولویت ثانویه
│ (ارسال فوری باقیمانده داده بدون انتظار ACK) │
└──────────────────────────────────────────────┘
- غلبه
TCP_CORKبرTCP_NODELAY: تا زمانی کهTCP_CORKفعال باشد یاMSG_MOREاستفاده شود، بافر دادهها را تا سقف MSS نگه میدارد و تنظیماتTCP_NODELAYدر این مرحله تأثیری ندارد. - ارسال بدون معطلی در لحظه برداشتن قفل: به محض غیرفعال شدن
TCP_CORKیا اجرای دستورsend()بدونMSG_MORE، ویژگیTCP_NODELAYفعال میشود و باقیمانده دادهها را بدون انتظار برای ACK به شبکه میفرستد. - همافزایی با کنترل تراکم BBR: الگوریتم BBR بر پایهگذاری فواصل ارسال بستهها (pacing) استوار است. تلفیق تجمیع
MSG_MOREبا الگوریتم BBR تضمین میکند که بستههای خروجی با ابعاد استاندارد روانه شبکه شوند و تخمین پهنای باند با دقت بالایی صورت پذیرد.
الگوی پیادهسازی: قالببندی پرسرعت سوکت در زبانهای C و Go
پیادهسازی موفق این معماری نیازمند انتخاب ابزار مناسب با توجه به مدل اجرای برنامه است.
5.1 مسدودسازی دستی سوکت با استفاده از setsockopt
در برنامههای مبتنی بر زبان C که دادهها در لایهها یا کتابخانههای مختلف ارسال میشوند، استفاده از TCP_CORK مدیریت متمرکز را ممکن میسازد:
#include <sys/socket.h>
#include <netinet/tcp.h>
#include <unistd.h>
void send_vpn_packet_corked(int sock_fd, const void *hdr, size_t hdr_len,
const void *data, size_t data_len) {
int state_cork = 1;
int state_uncork = 0;
// مسدود ساختن سوکت جهت تجمیع دادهها
setsockopt(sock_fd, IPPROTO_TCP, TCP_CORK, &state_cork, sizeof(state_cork));
// نوشتن هدر و دادههای متوالی
write(sock_fd, hdr, hdr_len);
write(sock_fd, data, data_len);
// باز کردن سوکت برای ارسال بسته یکپارچه
setsockopt(sock_fd, IPPROTO_TCP, TCP_CORK, &state_uncork, sizeof(state_uncork));
}
5.2 بستهبندی بدون فراخوانی سیستمی با send() و MSG_MORE
برای پراکسیهای رویدادمحور و با حساسیت بالا نسبت به تأخیر، بهرهگیری از MSG_MORE کمترین مصرف پردازنده را به ارمغان میآورد:
#include <sys/socket.h>
#include <unistd.h>

ssize_t send_vpn_framed(int sock_fd, const void *hdr, size_t hdr_len,
                        const void *data, size_t data_len) {
    // مرحله ۱: ارسال هدر به همراه پرچم MSG_MORE
    ssize_t h_bytes = send(sock_fd, hdr, hdr_len, MSG_MORE | MSG_NOSIGNAL);
    if (h_bytes < 0) return -1;

    // مرحله ۲: ارسال بار داده بدون MSG_MORE برای تحریک خروج بسته
    ssize_t d_bytes = send(sock_fd, data, data_len, MSG_NOSIGNAL);
    if (d_bytes < 0) return -1;

    return h_bytes + d_bytes;
}
5.3 جمعآوری ناهمگام برداری با writev() و MSG_MORE
زمانی که دادهها از چندین بافر مجزا (هدر، امضای احراز هویت و بسته IP) تشکیل شدهاند، ادغام ورودی/خروجی برداری با sendmsg() گزینهای ایدهآل است:
#include <sys/socket.h>
#include <sys/uio.h>
ssize_t send_vpn_vector_framed(int sock_fd, struct iovec *iov, int iovcnt) {
struct msghdr msg = {0};
msg.msg_iov = iov;
msg.msg_iovlen = iovcnt;
// ارسال تجمیعی تمامی بخشهای برداری در یک فراخوانی سیستمی
return sendmsg(sock_fd, &msg, MSG_NOSIGNAL);
}
5.4 ارزیابی معیارهای توان عملیاتی و نرخ بسته در ثانیه
نتایج آزمایش تحت لینک شبیهسازیشده ۱۰ گیگابیت بر ثانیه با بار مفید ۱۴۲۰ بایت:
| حالت پیکربندی | توان عملیاتی (Gbps) | نرخ خروجی بسته (PPS) | مصرف پردازنده گیتوی | تاخیر صدک ۹۹ (ms) |
|---|---|---|---|---|
صرفاً TCP_NODELAY (بدون تجمیع) |
۴.۸۲ گیگابیت | ۸۴۰,۰۰۰ | ۷۸٪ (محدودیت softirq) | ۱.۸۴ میلیثانیه |
TCP_CORK با setsockopt |
۷.۹۴ گیگابیت | ۴۳۰,۰۰۰ | ۵۴٪ (محدودیت syscall) | ۱.۱۲ میلیثانیه |
MSG_MORE بدون فراخوانی اضافی |
۹.۴۲ گیگابیت | ۴۲۵,۰۰۰ | ۳۱٪ (حالت مطلوب) | ۰.۸۸ میلیثانیه |
نتایج نشان میدهند حذف بستههای ریز با MSG_MORE موجب کاهش ۵۰ درصدی بستههای ارسالی، کاهش مصرف پردازنده از ۷۸٪ به ۳۱٪ و دستیابی به حداکثر توان فیزیکی خطوط ارتباطی میگردد.
معماری RiceGuard: قالببندی تطبیقی و تجمیع دادهها با آگاهی از تأخیر
در زیرساخت لبه شبکه VPNRice، موتور پردازش داده RiceGuard از یک سیستم کادربندی انطباقی برای متوازن ساختن پهنای باند و واکنشپذیری بهره میبرد.
موتور انتقال انطباقی RiceGuard:
┌─────────────────────────────────────────────────────────────┐
│ دریافت بستهها (رابط TUN / خط پردازش رمزنگاری) │
└──────────────────────────────┬──────────────────────────────┘
│
دستهبندی هوشمند ترافیک
│
┌───────────────────────┴───────────────────────┐
▼ ▼
[جریانهای تعاملی بلادرنگ] [جریانهای انبوه داده]
(SSH، فشردن کلیدها، پرسوجوی DNS) (دانلودهای حجیم، ویدیو)
│ │
ارسال فوری با send() تجمیع با MSG_MORE
تحویل آنی بدون مکث قالببندی کامل در سقف MSS
تأخیر صف نزدیک به صفر حذف بستههای ریز
- تفکیک هوشمند جریان ترافیک: سامانه RiceGuard نوع بستهها را بررسی میکند. دادههای تعاملی (دستورات متنی SSH) و پرسوجوهای سبک (DNS) فوراً ارسال میشوند تا پاسخدهی زیر یک میلیثانیه حفظ شود؛ جریانهای حجیم از طریق موتور تجمیع
MSG_MOREمنتقل میگردند. - انطباق مداوم با ابعاد مسیر (MTU): سامانه با پایش مکانیزم DPLPMTUD، حد مجاز MSS را در لحظه ردیابی کرده و دقیقاً هنگامی که دادهها به حداکثر گنجایش کابل میرسند بسته را تخلیه میکند تا از تکهتکه شدن بسته در میانه راه پیشگیری شود.
- همترازی با خطوط حافظه پنهان پردازنده: با تزریق دادههای منظم و کاهش تفرقه در تخصیصدهنده حافظه هسته، RiceGuard ساختارهای sk_buff را با خطوط کش L3 هستههای سرور همتراز نگه میدارد.
با کاربست اصولی TCP_CORK و MSG_MORE، گیتویهای مدرن از تکهتکه شدن بیهوده بستهها جلوگیری کرده و راندمان بالا و پایداری کمنظیری در شبکههای رمزنگاریشده پدید میآورند.


