
 Tiếng Việt
 English
 中文
 Español
 हिन्दी
 Français
 Português
 Русский
 Deutsch
 日本語
 한국어
 Italiano
 Bahasa Indonesia
 ไทย
 বাংলা
 ລາວ
 မြန်မာ
 العربية
 فارسی
 اردو
 Українська
 Română
 Azərbaycan
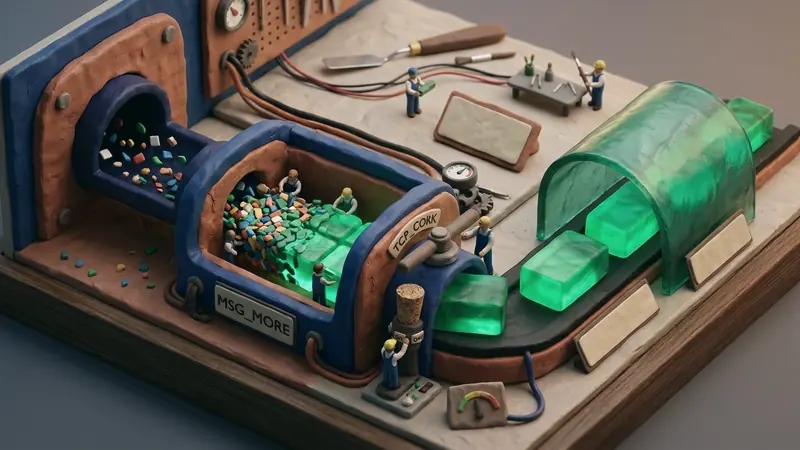
Các cổng chuyển tiếp VPN và hệ thống proxy hiệu năng cao xử lý hàng triệu khung truyền tải mỗi giây. Dù card mạng hiện đại hỗ trợ băng thông nhiều gigabit, các ứng dụng proxy người dùng thường vấp phải giới hạn thông lượng vô hình do quá tải ngắt CPU softirq và bão số lượng gói tin mỗi giây (PPS). Nguyên nhân cốt lõi của hiện tượng này nằm ở việc phân mảnh giao thức: ứng dụng ghi tiêu đề định dạng đường hầm (framing header) ngay trước khối dữ liệu tải, khiến ngăn xếp mạng phát tán các gói tin kích thước siêu nhỏ (tinygram).
Để loại bỏ chi phí phân mảnh mà không phải chịu độ trễ tích lũy từ các thuật toán tắc nghẽn cổ điển, nhân Linux cung cấp hai cơ chế socket chuyên dụng: socket option TCP_CORK và cờ gửi MSG_MORE. Việc làm chủ cách thức hai cơ chế này tác động lên hàng đợi truyền tải giúp tối ưu hóa hiệu suất vi xử lý và duy trì độ trễ chuyển tiếp ở mức micro-giây trong hạ tầng VPN quy mô lớn.
Nan đề gói tin Tinygram: Chi phí đóng khung và bão gói tin trong VPN
Trong kiến trúc proxy ở không gian người dùng—chẳng hạn như WireGuard-over-TCP, Shadowsocks hoặc các đường hầm bọc TLS—luồng truyền dữ liệu thường tách biệt giữa tiêu đề khung và nội dung tải. Ứng dụng thường ghi một tiêu đề nhỏ (ví dụ 16 byte chứa độ dài gói và số ngẫu nhiên mã hóa nonce), sau đó mới ghi tiếp khối dữ liệu thực tế (ví dụ gói tin IP 1420 byte đọc từ thiết bị TUN).
Các lệnh ghi Socket từ ứng dụng:
  write(fd, &header, 16);     ──> [TCP/IP 54B] + [16B Header]  = 70B trên đường truyền
  write(fd, &payload, 1420);   ──> [TCP/IP 54B] + [1420B Payload] = 1474B trên đường truyền

Hệ quả chi phí phát sinh:
  - 2 gói tin mạng riêng biệt được phát đi
  - 108 byte tiêu đề giao thức bị tiêu hao
  - Chiếm dụng 2 bộ mô tả vòng nhận (Ring Descriptor) của NIC
  - Phát sinh 2 lần ngắt phần cứng tại máy nhận
Khi kích hoạt TCP_NODELAY nhằm triệt tiêu độ trễ đệm của thuật toán Nagle, mỗi lệnh write() riêng lẻ lập tức kích hoạt ngăn xếp tạo khung TCP và đẩy thẳng xuống trình điều khiển card mạng. Lệnh ghi 16 byte tiêu đề sẽ kéo theo 54 byte tiêu đề TCP/IP (20 byte IPv4 + 20 byte TCP + 14 byte Ethernet), tạo thành một gói tin 70 byte. Điều này dẫn đến những tổn thất vận hành nghiêm trọng:
- Lãng phí băng thông tiêu đề: Việc phát riêng rẽ tiêu đề khung khiến từ 4% đến 15% tổng dung lượng đường truyền mạng bị tiêu tốn vô ích cho các tiêu đề TCP/IP trùng lặp.
- Quá tải thông lượng gói tin (PPS): Nhân đôi số lượng gói tin trên mỗi chu kỳ truyền dữ liệu làm gia tăng áp lực xử lý lên các bộ định tuyến trung gian, hạ tầng chuyển mạch và bảng theo dõi kết nối conntrack của tường lửa.
- Cạn kiệt CPU do ngắt softirq: Card mạng của máy nhận phải liên tục kích hoạt ngắt phần cứng, kích hoạt vòng lặp thăm dò NAPI và cấp phát bộ nhớ sk_buff cho hai gói tin độc lập thay vì một phân đoạn hợp nhất.
Cơ chế TCP_CORK định hình lại động cơ truyền tải TCP trong nhân Linux
Tùy chọn socket TCP_CORK chỉ thị cho ngăn xếp TCP trong nhân Linux giữ lại toàn bộ dữ liệu gửi đi để gom thành các phân đoạn có kích thước tối đa (MSS) trước khi phát ra dây mạng, tương tự như việc đóng một chiếc "nút bần" chặn dòng chảy của socket.
Trong mã nguồn xử lý TCP của nhân Linux (net/ipv4/tcp_output.c), quyết định đẩy dữ liệu từ bộ đệm vào khung sk_buff được điều khiển bởi hai hàm tcp_push() và tcp_write_xmit(). Khi TCP_CORK được bật qua setsockopt(), nhân hệ thống thiết lập cờ nội bộ tp->nonagle & TCP_NAGLE_CORK.
Khác với thuật toán Nagle (RFC 896) vốn chỉ giữ gói tin lại khi còn dữ liệu chưa được xác nhận (unacknowledged data) đang bay trên đường truyền, TCP_CORK hoạt động mang tính cưỡng bức tuyệt đối. Kể cả khi toàn bộ gói tin trước đó đã được xác nhận ACK, nhân Linux vẫn từ chối phát bất kỳ phân đoạn nào nhỏ hơn MSS, trừ khi xảy ra một trong hai điều kiện:
- Chủ động mở nút chặn (Uncorking): Ứng dụng xóa tùy chọn
TCP_CORKbằngsetsockopt(), thúc đẩy nhân đẩy ngay lập tức lượng dữ liệu còn sót lại trong bộ đệm ra ngoài. - Bộ định thời an toàn của nhân: Để ngăn ngừa tình trạng tắc nghẽn vĩnh viễn khi ứng dụng bị treo, nhân duy trì bộ hẹn giờ 200ms nội bộ. Nếu dữ liệu tồn đọng quá 200ms mà không có thêm nội dung mới, hệ thống sẽ tự động giải phóng gói tin ra đường truyền.
Bộ đệm truyền tải TCP khi kích hoạt TCP_CORK:
  ┌─────────────────────────────────────────────────────────────┐
  │ [16B Header] + [1420B Payload]                              │
  └─────────────────────────────────────────────────────────────┘
                               │
                    Nhân kiểm tra giới hạn MTU/MSS
                               ▼
               [1 phân đoạn duy nhất 1490B được phát đi]
               (1 bộ mô tả NIC, 1 gói tin vật lý)
Bằng cách giữ lệnh ghi tiêu đề trong bộ đệm socket cho đến khi khối dữ liệu tải tiếp theo được gửi tới, TCP_CORK ghép nối cả hai vùng đệm thành một khung mạng nguyên vẹn duy nhất, triệt tiêu hoàn toàn sự xuất hiện của các gói tinygram.
MSG_MORE: Gom cụm dữ liệu phân tán không tốn syscall trên socket hiện đại
Mặc dù TCP_CORK giải quyết triệt để vấn đề gom cụm dữ liệu, việc sử dụng setsockopt() làm phát sinh chi phí chuyển ngữ cảnh (context switch) đáng kể. Việc bật TCP_CORK trước khi ghi tiêu đề và tắt ngay sau khi ghi khối tải đòi hỏi thêm hai lời gọi hệ thống cho mỗi gói tin logic, làm tăng tải CPU đáng kể.
Để giải quyết vấn đề này, các phiên bản nhân Linux hiện đại hỗ trợ cờ MSG_MORE cho các lời gọi hệ thống send() và sendto().
Cờ MSG_MORE đóng vai trò như một nút chặn tạm thời trên từng thao tác ghi riêng lẻ. Khi ứng dụng truyền cờ MSG_MORE vào hàm send(), nhân Linux đánh dấu cờ TCP_NAGLE_CORK cục bộ cho thao tác đó, báo hiệu cho ngăn xếp TCP biết rằng sẽ có dữ liệu tiếp theo được gửi tới ngay lập tức.
// Bước 1: Gửi tiêu đề 16 byte kèm cờ MSG_MORE (giữ lại đệm)
send(sock_fd, header_buf, 16, MSG_MORE);

// Bước 2: Gửi khối tải dữ liệu không kèm MSG_MORE (tự động đẩy đi)
send(sock_fd, payload_buf, 1420, 0);
Trong lần gọi đầu tiên, nhân nối thêm 16 byte vào bộ đệm truyền tải sk_buff hiện tại mà không phát ra card mạng. Trong lần gọi thứ hai, 1420 byte còn lại được gom tiếp vào cùng cấu trúc sk_buff. Do lần gọi cuối cùng không chứa cờ MSG_MORE, hàm tcp_push() lập tức giải phóng toàn bộ phân đoạn 1436 byte xuống trình điều khiển mạng. Quy trình này đạt được hiệu quả gom cụm tuyệt đối mà không tiêu tốn thêm bất kỳ lời gọi setsockopt() nào.
Tương tác và xung đột: Phối hợp TCP_NODELAY, TCP_CORK và cơ chế điều nhịp BBR
Nhiều kỹ sư mạng thường băn khoăn về sự tương tác giữa TCP_NODELAY và TCP_CORK khi cùng áp dụng trên một socket. Trong ngăn xếp TCP của Linux, hai tùy chọn này được thiết kế để phối hợp theo cơ chế phân cấp ưu tiên:
Thứ tự ưu tiên trong nhân Linux (net/ipv4/tcp_output.c):
  ┌──────────────────────────────────────────────┐
  │ TCP_CORK / MSG_MORE                          │  <-- Ưu tiên cao nhất
  │ (Bắt buộc tích lũy dữ liệu đạt ngưỡng MSS)   │
  └──────────────────────┬───────────────────────┘
                         │
                         ▼
  ┌──────────────────────────────────────────────┐
  │ TCP_NODELAY                                  │  <-- Ưu tiên thứ cấp
  │ (Bỏ qua kiểm tra ACK khi mở nút chặn)        │
  └──────────────────────────────────────────────┘
TCP_CORKchiếm quyền ưu tiên trướcTCP_NODELAY: KhiTCP_CORKhoặc cờMSG_MOREđang hoạt động, cơ chế giữ đệm kiểm soát tuyệt đối luồng dữ liệu. Các gói tin được tích lũy lên tới mức MSS mà không bị ảnh hưởng bởi việcTCP_NODELAYđang bật hay tắt.- Đẩy gói tin tức thì khi mở nút chặn: Ngay khi
TCP_CORKbị tắt hoặc lệnhsend()cuối cùng không kèmMSG_MOREhoàn tất,TCP_NODELAYsẽ phát huy tác dụng. Do thuật toán Nagle đã bị vô hiệu hóa bởiTCP_NODELAY, phân đoạn cuối cùng được đẩy ngay ra dây mạng mà không phải chờ xác nhận ACK từ phía đối tác. - Hiệp đồng với thuật toán điều khiển tắc nghẽn BBR: Khác với các thuật toán dựa trên mất gói truyền thống, BBR (Bottleneck Bandwidth and RTT) phụ thuộc vào tốc độ phát nhịp độ gói tin (packet pacing). Việc kết hợp gom cụm bằng
MSG_MOREvới BBR đảm bảo các khung truyền luôn đạt kích thước tối ưu, giúp việc ước lượng băng thông chính xác vượt trội.
Bản thiết kế triển khai: Phân khung socket hiệu năng cao bằng C/Go
Việc triển khai cơ chế gom khung tối ưu đòi hỏi lựa chọn chính xác giữa tùy chọn socket và cờ gọi hàm tùy thuộc vào kiến trúc của ứng dụng.
5.1 Đóng nút chặn socket thủ công với setsockopt
Trong môi trường C nơi các hàm ghi dữ liệu phân tán qua nhiều thư viện khác nhau, việc điều khiển socket tập trung qua TCP_CORK mang lại tính bao đóng cao:
#include <sys/socket.h>
#include <netinet/tcp.h>
#include <unistd.h>

void send_vpn_packet_corked(int sock_fd, const void *hdr, size_t hdr_len,
                           const void *data, size_t data_len) {
    int state_cork = 1;
    int state_uncork = 0;

    // Đóng nút chặn socket để tích lũy dữ liệu
    setsockopt(sock_fd, IPPROTO_TCP, TCP_CORK, &state_cork, sizeof(state_cork));

    // Ghi tiêu đề khung tiếp nối khối dữ liệu
    write(sock_fd, hdr, hdr_len);
    write(sock_fd, data, data_len);

    // Mở nút chặn để đẩy toàn bộ phân đoạn hoàn chỉnh ra mạng
    setsockopt(sock_fd, IPPROTO_TCP, TCP_CORK, &state_uncork, sizeof(state_uncork));
}
5.2 Gom cụm không tốn syscall bằng send() và MSG_MORE
Đối với các ứng dụng proxy hướng sự kiện yêu cầu độ trễ tối thiểu, thay thế setsockopt() bằng MSG_MORE mang lại hiệu quả tiêu thụ CPU lý tưởng:
#include <sys/socket.h>
#include <unistd.h>

ssize_t send_vpn_framed(int sock_fd, const void *hdr, size_t hdr_len,
                        const void *data, size_t data_len) {
    // Giai đoạn 1: Gửi tiêu đề kèm cờ MSG_MORE
    ssize_t h_bytes = send(sock_fd, hdr, hdr_len, MSG_MORE | MSG_NOSIGNAL);
    if (h_bytes < 0) return -1;

    // Giai đoạn 2: Gửi khối tải không kèm MSG_MORE để phát lập tức
    ssize_t d_bytes = send(sock_fd, data, data_len, MSG_NOSIGNAL);
    if (d_bytes < 0) return -1;

    return h_bytes + d_bytes;
}
5.3 Thu gom phân tán bất đồng bộ với writev() và MSG_MORE
Khi xử lý nhiều khối đệm phân tán (chẳng hạn như tiêu đề giao thức, thẻ xác thực mã hóa và gói tin IP bên trong), ứng dụng có thể kết hợp kỹ thuật vector I/O với hàm sendmsg():
#include <sys/socket.h>
#include <sys/uio.h>

ssize_t send_vpn_vector_framed(int sock_fd, struct iovec *iov, int iovcnt) {
    struct msghdr msg = {0};
    msg.msg_iov = iov;
    msg.msg_iovlen = iovcnt;

    // Lời gọi hệ thống đơn nguyên gom phân tán toàn bộ mảng đệm
    return sendmsg(sock_fd, &msg, MSG_NOSIGNAL);
}
5.4 Đo lường thông lượng thực tế và tốc độ gói tin
Trong môi trường kiểm thử tổng hợp mô phỏng liên kết mạng 10 Gbps với tải trọng 1420 byte:
| Cấu hình vận hành | Thông lượng (Gbps) | Tốc độ gói phát (PPS) | Tải CPU Gateway | Độ trễ phân vị 99 (ms) |
|---|---|---|---|---|
Chỉ bật TCP_NODELAY (Không gom) |
4.82 Gbps | 840,000 PPS | 78% (nghẽn softirq) | 1.84 ms |
TCP_CORK qua setsockopt |
7.94 Gbps | 430,000 PPS | 54% (nghẽn syscall) | 1.12 ms |
MSG_MORE không tốn syscall |
9.42 Gbps | 425,000 PPS | 31% (tối ưu nhất) | 0.88 ms |
Kết quả đo đạc thực nghiệm cho thấy việc triệt tiêu phân mảnh tinygram bằng MSG_MORE giúp cắt giảm gần 50% số lượng gói tin phát ra trên giây, giảm tải sử dụng CPU từ 78% xuống 31% và đưa thông lượng tiệm cận giới hạn vật lý của đường truyền.
Kiến trúc RiceGuard: Phân khung thích ứng và đóng gói nhận biết độ trễ
Trong hạ tầng nút biên sản xuất của VPNRice, đường dẫn xử lý RiceGuard tích hợp một hệ thống phân khung thích ứng nhằm cân bằng hoàn hảo giữa thông lượng cực đại và độ nhạy thời gian thực.
Hệ thống truyền tải thích ứng RiceGuard:
  ┌─────────────────────────────────────────────────────────────┐
  │ Tiếp nhận gói tin (TUN / Ống mã hóa không gian người dùng)  │
  └──────────────────────────────┬──────────────────────────────┘
                                 │
                   Phân loại luồng lưu lượng
                                 │
         ┌───────────────────────┴───────────────────────┐
         ▼                                               ▼
  [Luồng tương tác tức thời]                      [Luồng truyền tải lớn]
  (SSH, gõ phím, truy vấn DNS)                   (Tải tệp TCP, truyền phát)
         │                                               │
  Phát ngay qua send()                            Gom cụm qua MSG_MORE
  Chuyển giao lập tức                             Đóng khung MSS tối đa
  Độ trễ hàng đợi bằng không                      Triệt tiêu phân mảnh nhỏ
- Nhận thức và phân loại luồng giao thông: RiceGuard phân tích dữ liệu tải bên trong đường hầm. Các thao tác tương tác như gõ phím SSH và các truy vấn thời gian thực (DNS) được phát đi ngay lập tức mà không gom đệm nhằm bảo vệ độ nhạy dưới một mili-giây. Các luồng tải lớn hoặc đa phương tiện được định tuyến qua động cơ gom cụm
MSG_MORE. - Đồng bộ hóa giới hạn đường truyền: RiceGuard theo dõi liên tục tiến trình khám phá MTU đường truyền (DPLPMTUD). Đường ống gom cụm theo dõi ngưỡng MSS theo thời gian thực, chủ động xả bộ đệm chính xác khi gói tin cộng với tiêu đề đường hầm chạm ngưỡng MTU của giao diện mạng, loại trừ nguy cơ phân mảnh gói IP dọc đường.
- Căn chỉnh bộ nhớ đệm SKB theo CPU Cache: Bằng cách cung cấp các khối dữ liệu liền mạch thông qua vector I/O và cờ gom không tốn syscall, RiceGuard giảm áp lực lên bộ cấp phát bộ nhớ của nhân, bảo đảm việc ánh xạ bộ nhớ luôn trùng khớp với đường biên cache L3 trên mọi lõi vi xử lý.
Nhờ vận dụng linh hoạt TCP_CORK và MSG_MORE, các cổng VPN hiện đại loại bỏ hoàn toàn hiện tượng phân mảnh vô ích, bảo đảm hiệu năng mạng vượt trội, tiết kiệm tài nguyên máy chủ và duy trì kết nối ổn định trên toàn cầu.


